برچسب: کامپیوتر و سخت افزار

1 دقیقه زمان مطالعه

شرکت MSI به پیروی از ایسوس و گیگابایت، قیمت کارت‌های گرافیک را بیش از ۲۰ درصد افزایش داد

شرکت MSI به پیروی از ایسوس و گیگابایت، قیمت کارت‌های گرافیک را بیش از ۲۰ درصد افزایش داد ام‌اس‌آی آخرین شریک تولیدکننده برد (AIB) انویدیا است که به‌دلیل کمبودهای مداوم حافظه DRAM، قیمت کارت‌های گرافیک خود را افزایش داده است. اگر گزارش‌ها را درباره کمبودهای مداوم حافظه و افزایش قیمت قطعات رایانه دنبال کرده باشید، می‌دانید که وضعیت در ماه‌های آینده بسیار وخیم‌تر خواهد شد. گزارش قبلی به افزایش قیمت عمده در تمامی برندها در اواخر ماه ژوئیه در چین اشاره کرد. حتی مصرف‌کنندگان داخلی چین از میزان این افزایش قیمت‌ها شوکه شده بودند و اخیراً شرکت‌های AIB رسماً افزایش قیمت‌های بیشتری را برای ماه آگوست اعلام کردند. ایسوس و گیگابایت جزو اولین تولیدکنندگان کارت گرافیک بودند که افزایش قیمت‌های خود را به شرکای توزیع‌کننده اعلام کردند و اکنون دیگران نیز از آن‌ها پیروی می‌کنند. امروز، شرکت ام‌اس‌آی به‌طور رسمی اعلام کرد که محصولات گرافیکی آن به‌دلیل کمبود حافظه شاهد افزایش قیمت بیش از ۲۰ درصدی خواهند بود. بر اساس اطلاعات نقل‌شده از منابع بورد چنلز (Board Channels)، تمامی مدل‌ها از سری RTX 50 گرفته تا سری RTX 30 تحت تأثیر قرار خواهند گرفت. شرکت ام‌اس‌آی به‌طور رسمی مدل 5090 D V2 (با ظرفیت ۲۴ گیگابایت) را لیست نکرده است، اما مدل 5080 افزایشی تا سقف ۲۱۰۰ یوان معادل بیش از ۳۰۰ دلار را تجربه خواهد کرد. مدل RTX 5070 Ti افزایشی تا ۱۳۵۰ یوان معادل ۲۰۰ دلار را خواهد دید. مدل‌های RTX 5060 Ti هشت گیگابایتی و RTX 5060 افزایشی بین ۹۰ تا ۱۰۰ دلار آمریکا خواهند داشت، درحالی‌که مدل RTX 5050 تا ۸۰ دلار گران‌تر خواهد شد. بیانیه افزایش قیمت کارت گرافیک ایسوس: «کارخانه کارت گرافیک ایسوس آخرین سیاست تنظیم قیمت مدیران را اجرا کرد که قیمت‌ها را در تمامی مدل‌ها افزایش داد و میزان افزایش نیز طبق افزایش حدود ۲۰ درصدی انویدیا بسیار بالا بود. سیاست تنظیم قیمت مدیران که در ماه آگوست در مقایسه با ماه ژوئیه اجرا شد به تفصیل به شرح زیر اعلام شد.» بیانیه افزایش قیمت کارت گرافیک گیگابایت: «روز گذشته، کارخانه کارت گرافیک به‌طور رسمی آخرین سیاست قیمت‌گذاری شهری را اجرا کرد که تمامی مدل‌ها را در ماه آگوست در مقایسه با ماه ژوئیه پوشش می‌دهد و افزایش قیمت حدود ۲۰ درصد است. سیاست پایه تنظیم قیمت شهری کارخانه در ماه آگوست به شرح زیر اعلام شد.» بیانیه افزایش قیمت کارت گرافیک ام‌اس‌آی: «کارخانه گرافیک ام‌اس‌آی سیستم قیمت‌گذاری جدید نمایندگی را اجرا می‌کند که تمامی مدل‌ها را با افزایش قیمت جامع پوشش می‌دهد، میزان افزایش نیز بسیار بالاست و مطابق با افزایش قیمت حدود ۲۰ درصد یا بیشتر انویدیا است. کارخانه کارت گرافیک میکرواستار (ام‌اس‌آی) به‌طور رسمی قیمت جدید نمایندگی را در ماه آگوست اجرا کرد و جزئیات تنظیم قیمت در مقایسه با ماه ژوئیه به شرح زیر افشا شده است.» تمامی این موارد افزایش قیمت‌های چشمگیری هستند و با توجه به اینکه بیشتر تولیدکنندگان حافظه قبلاً اعلام کرده‌اند که کمبودهای DRAM در سال‌های ۲۰۲۷ و ۲۰۲۸ شدت خواهد گرفت، به‌نظر می‌رسد هیچ نجاتی در افق دید سازندگان معمولی رایانه و گیمرها وجود ندارد. READ میمونی که با ایمپلنت مغزی نیورالینک، بازی کامپیوتری می‌کند [تماشا کنید]حتی مدل‌های قدیمی‌تر مانند سری Radeon RX7000 و سری RTX30 نیز تحت تأثیر این افزایش قیمت‌ها قرار گرفته‌اند. ما همچنین گزارش‌هایی را درباره انبار کردن کارت‌های گرافیک توسط خرده‌فروشان و فروش آن‌ها پس از افزایش بیشتر قیمت‌ها پوشش داده‌ایم. این روندی مداوم در آینده خواهد بود. برای بدتر شدن اوضاع، تحلیلگران پژوهشی از قبل درباره جهش ۵۰ درصدی قیمت‌های DRAM در سه ماهه سوم سال ۲۰۲۶ و به‌دنبال آن جهش ۴۰ درصدی دیگر در سه ماهه چهارم سال ۲۰۲۶ هشدار داده‌اند. افزایش قیمت‌ها محدود به محصولات جدید DRAM نیست، بلکه استانداردهای حافظه قدیمی‌تر نیز به‌طور مساوی تحت تأثیر قرار گرفته‌اند. این امر به کاهش شدید محموله‌های رایانه شخصی منجر شده است و می‌توان انتظار داشت که این بخش، ازجمله بازار کارت گرافیک، در آینده بیشتر تحت تأثیر بازار قرار گیرد.

مدیر 3 ماه قبل
1 دقیقه زمان مطالعه

تراشه RTX Spark انویدیا شکاف عملکرد چندهسته‌ای با تراشه اپل M4 Max را کاهش داد

تراشه RTX Spark انویدیا شکاف عملکرد چندهسته‌ای با تراشه اپل M4 Max را کاهش داد پیش از معرفی رسمی RTX Spark توسط انویدیا، تراشه‌ای با نام N1X نتایج ناامیدکننده‌ای را در بخش تک‌هسته‌ای و چندهسته‌ای در بنچمارک Geekbench 6 به نمایش گذاشته بود و نتوانسته بود تراشه نسل قبلی اپل یعنی M3 Max را شکست دهد. اکنون یک افشای اطلاعات تازه بهبودهایی را از سوی سیلیکون مبتنی‌بر آرم نشان می‌دهد؛ زیرا این تراشه موفق شده است شکاف عملکرد چندهسته‌ای را با تراشه ۱۴ هسته‌ای M4 Max شرکت اپل کاهش دهد. دو لپ‌تاپ با ۶۴ گیگابایت حافظه یکپارچه در پایگاه داده Geekbench 7 شناسایی شده‌اند؛ به‌طوری‌که یکی از مدل‌ها به نام «OEMQAJ 766_MIS Product Name DV» دارای پردازنده مرکزی ۲۰ هسته‌ای است، درحالی‌که نسخه ۱۸ هسته‌ای RTX Spark با نام «OEMQAJ OEMQAJ Product» شناخته می‌شود. امتیازات تک‌هسته‌ای هر دو نسخه به پای جدیدترین اعضای خانواده اپل سیلیکون نمی‌رسد، اما امتیازات چندهسته‌ای آن‌ها برای بحث کردن بسیار جذاب‌تر است. نسخه پردازنده مرکزی ۲۰ هسته‌ای RTX Spark به ترتیب امتیازات تک‌هسته‌ای و چندهسته‌ای ۲,۵۷۰ و ۲۳,۱۲۶ را به‌دست آورد، درحالی‌که نسخه ۱۸ هسته‌ای امتیازات ۲,۵۴۱ و ۲۱,۷۷۶ را کسب کرد. در مقایسه، نسخه ۱۴ هسته‌ای M4 Max جایگاه خود را در بخش تک‌هسته‌ای با امتیاز ۳,۴۰۴ و در بخش چندهسته‌ای با نتیجه ۲۵,۹۵۷ تثبیت کرد. با نگاهی به این ارقام، نسخه قدرتمندتر RTX Spark در نتیجه چندهسته‌ای Geekbench 7 تنها ۱۱ درصد کندتر از M4 Max است، اما این شکاف در عملکرد تک‌هسته‌ای به رقم قابل توجه ۲۴.۵ درصد افزایش می‌یابد. هنگام مقایسه دو نسخه RTX Spark، پردازنده مرکزی ۲۰ هسته‌ای در عملکرد تک‌هسته‌ای ۱.۱۴ درصد سریع‌تر و در رده چندهسته‌ای ۶.۲ درصد سریع‌تر است. به لطف همکاری انویدیا با مدیاتک، تراشه RTX Spark توانست محقق شود و درحالی‌که پردازنده مرکزی آن می‌توانست نتایج بهتری ارائه دهد، پردازنده گرافیکی بلک‌ول همان چیزی است که صنعت برای دیدن آن آماده می‌شود. طبق یک درایور توسعه‌دهنده برای ویندوز ۱۱ آرم ۶۴، نسخه‌های ۱۸ و ۲۰ هسته‌ای دارای هسته‌های کودا (CUDA) متفاوتی خواهند بود. پردازنده گرافیکی نسخه کندتر دارای ۵,۱۲۰ از این هسته خواهد بود، درحالی‌که مدل رده‌بالا ۶,۱۴۴ هسته خواهد داشت. READ ال جی ساندبار خمیده و بی سیم HS8 را معرفی کردذکر این نکته مهم است که درحالی‌که پردازنده گرافیکی بلک‌ول در RTX Spark تعداد هسته‌های کودای مشابهی با کارت دسکتاپ RTX 5070 یا RTX 3080 دارد، هیچ تأییدیه‌ای وجود ندارد که هر دو تراشه گرافیکی عملکرد یکسانی داشته باشند. برای این منظور، باید منتظر بنچمارک‌های آینده باشیم. برای کسانی که علاقه دارند، می‌توانید برخی از بنچمارک‌های نمونه اولیه مایکروسافت سرفیس لپ‌تاپ اولترا را بررسی کنید، اما باید هشدار دهیم که نتایج واقعی به‌دلیل درایورهای تکمیل‌نشده متفاوت خواهد بود.

مدیر 3 ماه قبل
1 دقیقه زمان مطالعه

ایسوس قیمت کارت‌های گرافیک سری RTX 50 را تا ۴۹ درصد افزایش داد

ایسوس قیمت کارت‌های گرافیک سری RTX 50 را تا ۴۹ درصد افزایش داد شرکت‌های ایسوس و گیگابایت قیمت کارت‌های گرافیک سری RTX 50 انویدیا و سری AMD Radeon خود را به‌طور رسمی و به میزان چشمگیری افزایش داده‌اند. این دو شریک تجاری در اواخر ژانویه به‌دلیل ادامه بحران کمبود تراشه‌های حافظه DRAM، قیمت کارت‌های سری RTX 50 و RX 9000 را بین ۱۰ تا ۱۵ درصد بالا بردند، اما روند صعودی قیمت‌ها از آن زمان تاکنون با سرعت بیشتری ادامه داشته است. بارزترین نمونه این افزایش قیمت در کارت گرافیک RTX 5070 Ti نسخه ۱۶ گیگابایتی دیده می‌شود. این کارت در نوامبر ۲۰۲۵ با قیمتی حدود ۷,۲۰‌ یوان (تقریباً ۱,۰۶۴ دلار) به فروش می‌رسید، اما پس از ماه ژانویه قیمت آن به ۸,۰۰۰ یوان رسید. قیمت این مدل در هفته‌های گذشته ابتدا تا ۹,۲۹۹ یوان (حدود ۱,۳۷۴ دلار) و در آخرین تغییرات به ۱۰,۷۰۰ یوان (۱,۵۸۱ دلار) افزایش یافته است که از رشد ۴۹ درصدی نسبت به نرخ پایه نوامبر خبر می‌دهد. دلیل اصلی افزایش قیمت کارت گرافیک ایسوس کارت‌های سفارشی ایسوس نیز از این روند مستثنی نبوده و مدل TUF Gaming RTX 5080 که زمستان گذشته با قیمت ۱,۱۹۹ دلار عرضه می‌شد، اکنون در آمازون با تخفیف به قیمت ۱,۵۹۵ دلار درج شده که نشان‌دهنده جهش ۳۳ درصدی است. وضعیت برای مدل ROG Strix RTX 5080 OC به‌مراتب بدتر بوده و قیمت آن از ۱,۴۹۹ دلار زمان عرضه به ۲,۰۹۹ دلار رسیده است؛ نرخی که رشد ۴۰ درصدی را تجربه کرده و حتی از قیمت نسخه Founders Edition کارت گرافیک RTX 5090 خود انویدیا نیز فراتر رفته است. جزئیات میزان افزایش قیمت مدل‌های مختلف ایسوس به شرح زیر است: سری RTX 5090D V2: افزایش قیمت ۶۶۶ دلاری سری RTX 5080 و RTX 5070 Ti: افزایش قیمت ۲۲۲ تا ۲۵۲ دلاری سری RTX 5070 و RTX 5060 Ti نسخه ۱۶ گیگابایت: افزایش قیمت ۱۴۸ دلاری سری RTX 5060 Ti نسخه ۸ گیگابایت: افزایش قیمت ۹۶ تا ۱۰۴ دلاری سری RTX 5060 نسخه ۸ گیگابایت: افزایش قیمت ۸۹ تا ۱۰۱ دلاری سری RTX 5050: افزایش قیمت ۸۹ دلاری کارت AMD RX 9070 XT: افزایش قیمت ۱۷۰ دلاری کارت RX 9060 XT نسخه ۸ گیگابایت: افزایش قیمت ۷۴ تا ۹۶ دلاری READ ایسوس لپ تاپ تازه ای از سری VivoBook Pro با قیمت پایه 799 دلار را معرفی کردمیانگین افزایش قیمت محبوب‌ترین کارت‌های گرافیک حدود ۴۰ درصد برآورد می‌شود، اما با توجه به رشد ۲۰ تا ۳۰ درصدی قیمت عمده‌فروشی کیت‌های انویدیا، احتمال می‌رود قیمت‌های خرده‌فروشی تا پیش از پایان سال باز هم افزایش پیدا کند. محصولات شرکت AMD نیز شرایط مشابهی دارند و قیمت کیت‌های Radeon تا ماه ژوئیه حدود ۱۰ درصد گران‌تر شده است. با توجه به پیش‌بینی رشد ۱۸ درصدی قیمت قراردادهای DRAM در سه ماهه آینده، نباید به این زودی‌ها منتظر کاهش قیمت‌ها بود. یکی از دلایل اصلی این اصلاح قیمت توسط ایسوس و گیگابایت، افزایش هزینه حافظه‌های GDDR7 عنوان شده که میانگین هزینه تولید یک کارت گرافیک ۱۶ گیگابایتی را حدود ۱۵۰ دلار بالا برده است؛ هزینه‌ای که اکنون باید توسط خریدار نهایی پرداخت شود.

مدیر 3 ماه قبل
1 دقیقه زمان مطالعه

سامسونگ از اولین تراشه حافظه با بیش از ۴۰۰ لایه برای پردازش هوش مصنوعی رونمایی کرد

سامسونگ از اولین تراشه حافظه با بیش از ۴۰۰ لایه برای پردازش هوش مصنوعی رونمایی کرد سامسونگ در جریان نمایشگاه FMS 2026 در کنار معرفی مفهوم zHBM، از تراشه حافظه V10 BV-NAND رونمایی کرد. این محصول از نسل دهم معماری حافظه فلش V-NAND بهره می‌برد و یک ارتقای فنی بزرگ نسبت به نسل‌های قبلی تراشه‌های فلش محسوب می‌شود. سامسونگ در تولید این تراشه از فناوری جدید اتصال وافر استفاده کرده است و اولین شرکتی در این صنعت محسوب می‌شود که چنین معماری پیشرفته‌ای را به کار می‌گیرد. این تکنولوژی به شرکت اجازه می‌دهد بیش از ۴۰۰ لایه را روی یکدیگر قرار دهد که نتیجه آن افزایش ۵۸ درصدی تراکم حافظه در مقایسه با تراشه‌های نسل نهم است. این معماری جدید همچنین عملکرد خواندن، نوشتن و ورودی/خروجی را بهبود داده و بازدهی انرژی بهتری ارائه می‌دهد. تراشه V10 BV-NAND برای پردازش بارهای کاری سنگین و لحظه‌ای در سرورهای هوش مصنوعی (AI) طراحی شده است تا سرعت بالاتری ارائه دهد و مصرف انرژی را کاهش دهد. با‌این‌حال، سامسونگ هنوز زمان عرضه تجاری آن را اعلام نکرده است، ولی احتمال دارد این تراشه‌ها پیش از معرفی نسل بعدی یعنی V11 در سال ۲۰۲۷ روانه بازار شوند. علاوه‌بر این تراشه، غول فناوری کره‌ای از مدل مفهومی zHBM نیز رونمایی کرد؛ معماری جدیدی که حافظه HBM را به‌صورت عمودی دقیقاً روی شتاب‌دهنده‌های هوش مصنوعی قرار می‌دهد. این طراحی فاصله انتقال داده را به حداقل رسانده و پهنای باند را تا ۸ برابر نسبت به HBM5 افزایش می‌دهد. همچنین با بهره‌گیری از اتصال وافر، تراکم حافظه ۱۰ برابر و بازدهی انرژی ۳ برابر بهبود می‌یابد و مقاومت گرمایی را به نصف می‌رساند. READ پایان انحصار سامسونگ؛ تامین ۲۰ درصد از نمایشگرهای OLED آیفون۱۲ به ال‌جی سپرده شد سامسونگ همچنین راهکار zNAND-O را برای محیط‌های هوش مصنوعی در تجهیزات لبه (Edge AI) و پروژه‌های HBM4E و HBM5 را برای مرکز داده ارائه کرد. این شرکت به‌عنوان تنها سازنده یکپارچه در این حوزه، اعلام کرده خدمات کامل از طراحی تا تولید یکپارچه را به مشتریان خود ارائه می‌دهد تا دوره توسعه محصولات هوش مصنوعی را کوتاه‌تر کند.

مدیر 3 ماه قبل
1 دقیقه زمان مطالعه

کوچک‌ترین پردازنده گرافیکی جهان تست‌های واقعی را با موفقیت پشت‌سر گذاشت [تماشا کنید]

کوچک‌ترین پردازنده گرافیکی جهان تست‌های واقعی را با موفقیت پشت‌سر گذاشت [تماشا کنید] پردازنده گرافیکی TinyGPU v2.0 که به‌عنوان کوچک‌ترین تراشه گرافیکی جهان شناخته می‌شود، تست‌های واقعی را با موفقیت پشت‌سر گذاشت. این تراشه مینیاتوری که توسط توسعه‌دهنده‌ای به نام Pongsagon Vichit طراحی شده، توسط شرکت Tiny Tapeout و در قالب شاتل SKY 25b به تولید رسیده است. Vichit با انتشار ویدیوهایی در شبکه‌های اجتماعی، عملکرد عملی این تراشه مستقل را به نمایش گذاشته است. در ویدیوی اول، این پردازنده گرافیکی یک مدل سه‌بعدی را به‌صورت زنده و از طریق گیم‌پد رندر و کنترل می‌کند. در دموی دوم نیز پردازش یک کره زمین درحال چرخش و رنگارنگ با قابلیت تغییر مقیاس به تصویر کشیده شده است. Your browser does not support the video tag. طبق اطلاعات موجود در گیت‌هاب این پروژه، تراشه TinyGPU v2.0 توانایی انجام محاسبات هندسی و شطرنجی‌سازی را برای حداکثر ۱۰۰۰ مثلث روی صفحه دارد. این پردازنده با بهره‌گیری از حدود ۲۴۰ هزار ترانزیستور، از یک منبع نور پویا، سایه‌زنی تخت، حذف سطوح پشتی و نگاشت بافت بهره می‌برد. بافر دوگانه ۴ بیتی و بافر عمق ۸ بیتی آن نیز روی حافظه QSPI RAM ذخیره می‌شود. Your browser does not support the video tag. در آزمایش‌های انجام‌شده، نرخ فریم ثبت‌شده برای این پردازنده گرافیکی بین ۷.۵ تا ۱۵ فریم‌برثانیه بوده است. سازنده آن پیش‌تر اشاره کرده بود که نسخه سیلیکونی سرعت بیشتری نسبت به نمونه اولیه FPGA نخواهد داشت و در عملکرد واقعی نیز روانی تصویر تغییر چندانی نکرده است. هم‌زمان با تست نسخه دوم، جزئیات نسل بعدی یعنی TinyGPU v3.0 نیز مطرح شده است. ویژگی کلیدی در نسل سوم، اضافه شدن شیدر پیکسل برنامه‌پذیر است. این شیدر با الهام از طراحی DirectX 8 PS 1.1 ساخته شده و دارای معماری SIMD برای پردازش ۴ پیکسل به‌صورت موازی، مجموعه دستورالعمل‌های ۲۶ عملیاتی و انشعاب‌گیری از طریق اجرای ماسک‌شده است. READ با بخشنامه جدید تامین اجتماعی دورکاری رسمیت یافتانتظار می‌رود اضافه شدن شیدر پیکسل جدید به همراه دسترسی موازی به Z-Buffer، کیفیت بصری و جزئیات بافت‌ها را بدون کاهش محسوس عملکرد ارتقا دهد. طبق آخرین برنامه‌ریزی‌ها، تراشه نهایی TinyGPU v3.0 در دسامبر ۲۰۲۶ یا ژانویه ۲۰۲۷ تحویل داده خواهد شد.

مدیر 3 ماه قبل
1 دقیقه زمان مطالعه

شرکت چینی DFSX وعده سیستم ۱۴ نانومتری با پهنای باند دو برابر GB200 انویدیا را داد

شرکت چینی DFSX وعده سیستم ۱۴ نانومتری با پهنای باند دو برابر GB200 انویدیا را داد شرکت چینی Dongfang Suanxin یا به اختصار DFSX تلاش می‌کند ثابت کند که عامل اصلی افزایش مقیاس‌پذیری در بارهای کاری هوش مصنوعی، پهنای باند حافظه است، نه رقابت بی‌پایان برای کوچک‌تر کردن لیتوگرافی تراشه‌ها. این شرکت با تراشه‌های DF1000 و DF2000 که در قالب سوپرنودهای TY64 مورد استفاده قرار می‌گیرند، قصد دارد با سیستم GB200 NVL72 انویدیا رقابت کند. سوپرنود TY64 شرکت DFSX که از تراشه‌های DF2000 با فناوری ساخت ۱۴ نانومتری تشکیل شده است، پهنای باند حافظه معادل ۹۶۰ ترابایت‌برثانیه ارائه خواهد کرد. این رقم در مقایسه با ۵۷۶ ترابایت‌برثانیه سیستم NVIDIA GB200 NVL72 به‌مراتب بالاتر است. برای افرادی که با فناوری DFSX آشنایی ندارند، تراشه DF1000 با لیتوگرافی بالغ ۱۴ نانومتری تولید می‌شود، اما از معماری سه‌بعدی جدیدی موسوم به Near-Memory Compute بهره می‌برد. در این طراحی، حافظه مستقیماً روی لایه پردازشی قرار می‌گیرد و از طریق فناوری اتصال هیبریدی سه‌بعدی در سطح ویفر (3D Wafer-Level Hybrid Bonding) به آن متصل می‌شود. این فناوری با ادغام مسیرهای مسی دولایه، نیاز به Microbump یا سیم‌های ارتباطی را به‌طور کامل حذف کرده و ارتباطات عمودی بسیار پرسرعتی را میان بخش پردازشی و حافظه فراهم می‌کند؛ ارتباطی که DFSX آن را به میلیون‌ها آسانسور فوق‌سریع عمودی در برابر یک بزرگراه افقی تشبیه می‌کند. در مقابل، تراشه DF2000 که انتظار می‌رود در سه‌ماهه چهارم سال ۲۰۲۶ و همچنان با فناوری ساخت ۱۴ نانومتری معرفی شود، این ایده را یک گام فراتر می‌برد. به‌جای قرار دادن تنها یک لایه حافظه روی بخش پردازشی، DF2000 از چندین برج پردازش-حافظه در کنار یکدیگر روی یک بستر مشترک استفاده می‌کند. DFSX این فناوری را چیدمان 3.5D Infinity Chiplet می‌نامد. این تراشه در عمل لایه‌های ذخیره‌سازی متداول را با ساختاری اختصاصی از حافظه DRAM سه‌بعدی جایگزین می‌کند و در نتیجه حجم داده‌های موقتی که مستقیماً در ساختار تراشه نگهداری می‌شود، به شکل قابل‌توجهی افزایش می‌یابد. READ شرکت چینی علی‌بابا نیز به دنبال توسعه رقیب ChatGPT استهدف اصلی DFSX حل یکی از مشکلات همیشگی بارهای کاری هوش مصنوعی است؛ مشکلی که در آن پردازنده‌های گرافیکی بخش قابل‌توجهی از زمان خود را در انتظار دریافت داده از حافظه سپری می‌کنند. این شرکت معتقد است که «دیوار حافظه» (Memory Wall) بزرگ‌ترین مانع افزایش عملکرد در پردازش‌های هوش مصنوعی است. رقابت چین با انویدیا از طریق پهنای باند حافظه اکنون DFSX اعداد و ارقامی نیز برای پشتیبانی از این ادعا ارائه کرده است. هر تراشه DF2000 پهنای باند حافظه‌ای برابر با ۱۵ ترابایت‌برثانیه دارد و زمانی که ۶۴ عدد از این تراشه‌ها در قالب یک TY64 SuperNode کنار هم قرار می‌گیرند، مجموع پهنای باند حافظه به ۹۶۰ ترابایت‌برثانیه می‌رسد. این درحالی است که سیستم GB200 NVL72 انویدیا تنها ۵۷۶ ترابایت‌برثانیه پهنای باند حافظه در اختیار دارد. البته تفاوت میان یک تراشه ۴ نانومتری و یک تراشه ۱۴ نانومتری زمانی مشخص می‌شود که عملکرد محاسباتی BF16 آن‌ها مقایسه شود. سوپرنود TY64 مبتنی بر DF2000 توان پردازشی ۶۴ پتافلاپس BF16 ارائه می‌دهد، درحالی‌که سیستم GB200 NVL72 انویدیا به ۳۶۰ پتافلاپس BF16 دست پیدا می‌کند. بااین‌حال، DFSX امیدوار است پهنای باند حافظه تقریباً دو برابری بتواند ضعف توان پردازشی خام سوپرنود مبتنی بر DF2000 را جبران کند. به اعتقاد این شرکت، با بزرگ‌تر شدن مدل‌های زبانی بزرگ (LLM)، عامل محدودکننده اصلی عملکرد دیگر توان پردازشی هر تراشه نیست، بلکه عواملی مانند یکپارچه‌سازی سیستم، ظرفیت حافظه، پهنای باند حافظه، سرعت ارتباطات بین تراشه‌ها و زنجیره تأمین اهمیت بیشتری پیدا کرده‌اند. بر همین اساس، DFSX معتقد است که FLOPS معیار مناسبی برای ارزیابی عملکرد سیستم‌های هوش مصنوعی نیست و پهنای باند حافظه باید مهم‌ترین شاخص در این حوزه باشد. READ سایت های داخلی چین از استناد کردن به شبکه های اجتماعی در گزارشات خود منع شدنداین شرکت همچنین اعلام کرده است که تراشه DF3000 در آینده پهنای باند حافظه‌ای برابر با ۲۰ ترابایت‌برثانیه ارائه خواهد کرد که در قالب سوپرنود TY64 به ۱٬۲۸۰ ترابایت‌برثانیه خواهد رسید. در همین حال، سیستم NVIDIA Vera Rubin NVL72 پهنای باند حافظه‌ای برابر با ۱٬۵۸۰ ترابایت‌برثانیه ارائه می‌دهد که تنها ۲۳ درصد بیشتر از سوپرنود مبتنی بر DF3000 خواهد بود.

مدیر 3 ماه قبل
1 دقیقه زمان مطالعه

پردازش هوش مصنوعی در میدان جنگ؛ پالانتیر از دیتاسنترهای سیار کانتینری رونمایی کرد

پردازش هوش مصنوعی در میدان جنگ؛ پالانتیر از دیتاسنترهای سیار کانتینری رونمایی کرد شرکت پالانتیر با همکاری Armada، گام بزرگی در انتقال پردازش هوش مصنوعی به میدان‌های جنگ برداشته است. این دو مجموعه با استقرار دیتاسنترهای سیار در داخل کانتینرهای استاندارد کشتیرانی، امکان تحلیل اطلاعات نظامی را در خطوط مقدم نبرد و بدون نیاز به ارتباط پیوسته با فضای ابری مرکزی فراهم کرده‌اند. واحدهای کانتینری پالانتیر و آرمادا سیستم‌های خودکفایی هستند که کلیه تجهیزات مورد نیاز شامل سخت‌افزارهای پردازشی، آرایه‌های ذخیره‌سازی، تجهیزات شبکه و سیستم‌های خنک‌کننده پیشرفته را درون خود جای داده‌اند. برخلاف سیستم‌های متداول مبتنی‌بر فضای ابری، این دیتاسنترهای کانتینری می‌توانند داده‌ها را بدون برقراری اتصالات دائمی به زیرساخت‌های ابری پردازش کنند. سرورهای موجود در این کانتینرهای نظامی بر پایه تداشه‌های B300 انویدیا طراحی شده‌اند. معمار ارشد پالانتیر با انتشار جزئیاتی از درون یکی از این دیتاسنترهای کانتینری، اعلام کرد که این واحدها قابلیت اجرای مدل‌های وزن‌باز را در سخت‌ترین شرایط محیطی دارند. دیتاسنترهای سیار کانتینری پالانتیر برای پردازش هوش مصنوعی در شرایطی که الزامات امنیت عملیاتی سطح بالاتری از پنهان‌کاری را ایجاب کند، این واحدها قابلیت جداسازی کامل از شبکه‌های خارجی را دارند. این ویژگی امکان تحلیل اطلاعات نظامی و خروجی حسگرها را فراهم و نیاز به ارسال مداوم حجم زیادی از داده‌ها به سرورهای دوردست را برطرف می‌کند. استفاده از ساختار محاسباتی توزیع‌شده (Distributed Computing) نسبت به اتکای مطلق به دیتاسنتر متمرکز، تاب‌آوری شبکه نظامی را به بسیار ارتقا می‌دهد. در این معماری، قطع ارتباط منجر به از کار افتادن کل سیستم نخواهد شد؛ چرا که سایر واحدهای کانتینری به پردازش محلی اطلاعات ادامه می‌دهند. از دیدگاه فرماندهان نظامی، این امر هوش مصنوعی پیشرفته را به حسگرها، فرماندهان و واحدهای مختلف نزدیک‌تر می‌کند. این رویکرد وابستگی به خطوط ارتباطی را که در طول عملیات رزمی در معرض ارسال پارازیت، شنود یا تخریب فیزیکی هستند، کاهش می‌دهد. READ حضور دو پهپاد مشکوک باعث لغو پروازهای فرودگاهی در آمریکا شد

مدیر 3 ماه قبل
1 دقیقه زمان مطالعه

رقابت داغ رم‌های نسلی بعدی؛ تراشه‌ساز چینی آماده‌ تولید انبوه LPDDR6 می‌شود

رقابت داغ رم‌های نسلی بعدی؛ تراشه‌ساز چینی آماده‌ تولید انبوه LPDDR6 می‌شود شرکت چینی تولیدکننده حافظه‌های DRAM، یعنی CXMT، موفق شده مرحله ارزیابی و صحت‌سنجی تحقیق‌وتوسعه را برای حافظه‌های رم موبایل LPDDR6 خود به پایان برساند. این تراشه‌ها با مشخصاتی مانند حداکثر سرعت ۱۲.۸ گیگابیت‌برثانیه (سرعت پایه ۱۰.۷ گیگابیت‌برثانیه) و چگالی ۱۶ گیگابیتی وارد مرحله آزمایش‌های تولید در مقیاس کوچک شده‌اند تا برای تولید انبوه احتمالی آماده شوند. پیشروی CXMT در سایه بحران کمبود رم موبایل بازار جهانی گوشی‌های هوشمند هم‌اکنون با کمبود شدید حافظه دست‌وپنجه نرم می‌کند؛ چراکه غول‌های فناوری بخش زیادی از ظرفیت تولید خود را به سمت دیتاسنترهای عظیم هوش مصنوعی هدایت کرده‌اند. درحالی‌که شرکت‌های بزرگی مانند مایکرون و سامسونگ به شدت بر تولید DRAM‌های سرور با سودآوری بالا تمرکز کرده‌اند، شرکت چیپ‌سازی چینی CXMT از این فرصت برای پیشرفت در نسل بعدی رم‌های موبایل استفاده کرده است. اکنون گزارش‌ها نشان می‌دهند که CXMT به مراحل پایانی تأیید ارزیابی تحقیق‌وتوسعه حافظه LPDDR6 رسیده است. برای عرضه یک تراشه موبایل جدید به بازار، سازندگان باید چهار مرحله سخت‌گیرانه تأیید دای (Die) به‌صورت مجزا، ارزیابی تحقیق‌وتوسعه، تولید آزمایشی در مقیاس کوچک و در نهایت تولید انبوه را طی کنند. عبور از مرحله ارزیابی R&D به این معنی است که CXMT توانسته سازگاری، پایداری سیستم، قابلیت اطمینان مکانیکی و میزان مصرف انرژی را با موفقیت تست کند. این موضوع راه را برای آزمایش‌های تولید در مقیاس کوچک پیش از شروع تولید انبوه هموار می‌سازد. مشخصات فنی تراشه‌های LPDDR6 شرکت CXMT بسیار چشمگیر است. این حافظه با چگالی دای ۱۶ گیگابیتی، در سرعت پایه ۱۰,۶۶۷ مگابیت‌برثانیه (۱۰.۷ گیگابیت‌برثانیه) کار می‌کند و در طراحی خود به حداکثر سرعت ۱۲,۸۰۰ مگابیت‌برثانیه (۱۲.۸ گیگابیت‌برثانیه) دست می‌یابد. این تراشه نسبت به استانداردهای قدیمی‌تر LPDDR5X، کارایی انرژی به مراتب بالاتر و قابلیت اطمینان بهتری ارائه می‌دهد. این یک پیشرفت بزرگ در مقایسه با تراشه‌های LPDDR5 این شرکت است که در سال ۲۰۲۳ با ظرفیت ۱۲ گیگابایت و سرعت ۶,۴۰۰ مگابیت‌برثانیه عرضه شده بودند. READ ال‌جی اینوتک پتنت‌ها و تجهیزات LED خود را به یک شرکت چینی می‌فروشداین دستاوردهای فنی توضیح می‌دهند که چرا ارزش سهام CXMT در جریان عرضه اولیه عمومی (IPO) حدود ۴۶۶ درصد رشد داشت و به ۴۹ یوان (حدود ۶.۸ دلار) رسید. سال گذشته، تراشه‌های LPDDR حدود ۶۶.۴۳ درصد از درآمد این شرکت را تشکیل دادند و سهم رم‌های DDR نیز ۳۱.۸۷ درصد بود. در این میان، CXMT حتی توجه اپل را هم به خود جلب کرده است. گزارش‌ها نشان می‌دهند اپل احتمال تأمین حافظه‌های موردنیاز خود از CXMT را بررسی کرده تا فشار بر زنجیره تأمین جهانی کاهش یابد؛ اگرچه مقامات آمریکایی چندان از این ایده حمایت نمی‌کنند. در‌همین‌حین، رقیب اصلی CXMT یعنی SK Hynix فرایند عرضه رم‌های ۱۶ گیگابیتی LPDDR6 مبتنی بر لیتوگرافی 1c خود را سرعت بخشیده است تا بتواند مشتریان چینی مانند شیائومی را پیش از افزایش ظرفیت تولید CXMT به سمت خود جذب کند.

مدیر 3 ماه قبل
1 دقیقه زمان مطالعه

AMD پشتیبانی لینوکس از پردازشگرهای گرافیکی RDNA 5 را آماده می‌کند

AMD نخستین گام‌ها برای پشتیبانی از گرافیک‌های RDNA 5 در لینوکس را برداشت؛ پچ‌های جدید DCN6 پایه توسعه نسل آینده را فراهم می‌کنند. The post AMD پشتیبانی لینوکس از پردازشگرهای گرافیکی RDNA 5 را آماده می‌کند appeared first on دیجیاتو.

مدیر 3 ماه قبل
1 دقیقه زمان مطالعه

اینتل برای افزایش سرعت ساخت کارخانه اوهایو پاداش اضافه‌کار پرداخت می‌کند

در عین حال، بازدهی فناوری بسته‌بندی EMIB-T به ۹۰ درصد نزدیک شده است. The post اینتل برای افزایش سرعت ساخت کارخانه اوهایو پاداش اضافه‌کار پرداخت می‌کند appeared first on دیجیاتو.

مدیر 3 ماه قبل
1 دقیقه زمان مطالعه

یک یوتوبر دمای پردازنده رایزن 7 9800X3D را با خنک‌کننده دودکشی ۱۹ درجه پایین آورد

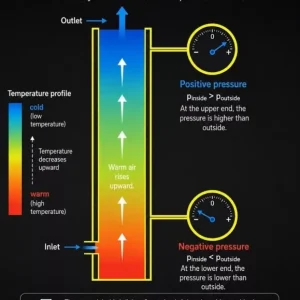
یک یوتوبر دمای پردازنده رایزن 7 9800X3D را با خنک‌کننده دودکشی ۱۹ درجه پایین آورد طراحی 3D V-Cache در پردازنده رایزن 7 9800X3D عملکرد بی‌نظیری در بازی‌ها ارائه می‌دهد، اما به‌عنوان یک پتوی حرارتی عمل می‌کند که توضیح می‌دهد چرا این پردازنده با وجود نصب خنک‌کننده مناسب، داغ‌تر از بیشتر مدل‌ها کار می‌کند. بااین‌حال، یک یوتوبر با توسعه یک دودکش که با پرینتر سه‌بعدی آن را چاپ کرده و ارتفاعش چند سانتی‌متر است، یک قدم فراتر رفته تا دما را به میزان چشمگیر ۱۹ درجه سانتی‌گراد کاهش دهد. تنها نکته منفی این است که قرار دادن این خنک‌کننده در کیس کامپیوتر کاربرهای عادی غیرممکن است. اثر «دودکش» به کاهش دما منجر می‌شود قطعات چاپ سه‌بعدی روی واترکولر پردازنده Ryzen 7 9800X3D نصب شدند تا مایع خنک‌کننده را به گردش درآورند؛ در همین حال، از یک رادیاتور ۲۴۰ میلی‌متریِ بدون فن برای دفع هوای گرم استفاده شد. در این پروژه، یوتوبر معروف حوزه سخت‌افزار موسوم به der8auer به جای استفاده از فن، محفظه‌هایی را طراحی کرد تا آن‌ها را روی یکدیگر قرار دهد. اتصال یک دودکش تک‌بخشیِ چاپ سه‌بعدی با ارتفاع ۲۰ سانتی‌متر نیز نتایج مثبتی به همراه داشت و توانست در شرایطی که پردازنده Ryzen 7 9800X3D حدود ۱۰۰ وات توان مصرف می‌کرد، دمای آن را تا حدودی کاهش دهد. با رسیدن ارتفاع این دودکش به ۱۱۰ سانتی‌متر (که تقریباً تا نزدیک سقف اتاق این یوتوبر می‌رسید)، دما به قدری افت کرد که der8auer به سختی می‌توانست اعداد ثبت‌شده را باور کند. این یوتوبر برای اثبات عملکرد سیستم خنک‌کننده ابداعی خود، از یک دستگاه مه‌ساز استفاده کرد تا به وضوح نشان دهد هوا چگونه به داخل محفظه کشیده می‌شود و «اثر دودکش» ایجاد می‌کند. READ گوگل یک مدل «زبان هوش مصنوعی» با یک تریلیون پارامتر را ایجاد کرددر حداکثر ارتفاع ممکن، دمای پردازنده Ryzen 7 9800X3D حدود ۱۹ درجه سانتی‌گراد افت کرد (از ۹۰ درجه به ۷۱ درجه سانتی‌گراد). این موضوع der8auer را به شدت تحت‌تأثیر قرار داد، چرا که در ویدیو اعتراف می‌کند اصلاً انتظار چنین نتایج فوق‌العاده‌ای را نداشته است. تنها نقطه ضعف برای کاربران عادی که می‌خواهند این روش را امتحان کنند، نیاز به فضای عمودی بسیار زیاد است. علاوه‌براین، علاقه‌مندان مجبورند تمام قطعات سیستم را روی یک تست‌بنچ (Test Bench) اسمبل کنند؛ زیرا عملاً هیچ راهی برای جای دادن این محفظه‌های مرتفع درون یک کیس استاندارد وجود ندارد.

مدیر 3 ماه قبل
1 دقیقه زمان مطالعه

سقوط تایتان‌های سیلیکونی: چرا کارت گرافیک پرمصرف و رویای SLI برای همیشه نابود شدند؟

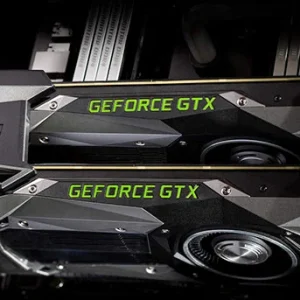
سقوط تایتان‌های سیلیکونی: چرا کارت گرافیک پرمصرف و رویای SLI برای همیشه نابود شدند؟ مقدمه: جنون قدرت در عصر طلایی سخت‌افزار در تاریخ تکامل کامپیوترهای شخصی، دورانی وجود داشت که منطق، جای خود را به جنون قدرت خالص داده بود. اگر امروز یک کارت گرافیک پرچمدار مانند RTX 4090 با ابعاد غول‌پیکر و مصرف انرژی سرسام‌آورش شما را متعجب می‌کند، احتمالاً روزهای باشکوه و در عین حال ترسناک دهه ۲۰۱۰ را به یاد نمی‌آورید. روزهایی که شرکت‌های انویدیا (Nvidia) و ای‌ام‌دی (AMD) در یک مسابقه تسلیحاتی بی‌رحمانه، هیولاهایی را روانه بازار می‌کردند که برای روشن شدن، به چیزی شبیه به یک نیروگاه برق هسته‌ای خانگی نیاز داشتند! در مرکز این مسابقه تسلیحاتی، یک رویای به ظاهر بی‌نقص وجود داشت: «اگر یک کارت گرافیک می‌تواند بازی‌ها را زیبا اجرا کند، چرا دو تا، سه تا یا حتی چهار کارت گرافیک را به هم متصل نکنیم تا به قدرت بی‌نهایت دست یابیم؟» این رویای شیرین که با نام‌های SLI در اردوگاه انویدیا و CrossFire در جبهه AMD شناخته می‌شد، برای بیش از یک دهه قلب تپنده سیستم‌های گیمینگ فوق‌حرفه‌ای (Enthusiast) بود. اما چه شد که این تکنولوژی جذاب، پس از خلق کارت‌های افسانه‌ای و پرمصرفی مانند GTX 690، به تدریج به یک کابوس فنی تبدیل شد و در نهایت به زباله‌دان تاریخ پیوست؟ این داستان صعود و سقوط باشکوه پردازش چندگانه در دنیای گرافیک است. فصل اول: تولد یک رویا؛ از 3dfx تا ظهور SLI و CrossFire برای درک این سقوط، باید به نقطه شروع بازگردیم. ایده اتصال دو کارت گرافیک برای اولین بار توسط شرکت افسانه‌ای 3dfx در سال 1998 با تکنولوژی Scan-Line Interleave (SLI) معرفی شد. در آن زمان، کارت‌های Voodoo 2 با استفاده از یک کابل به هم متصل می‌شدند و هر کدام نیمی از خطوط تصویر را پردازش می‌کردند. وقتی انویدیا در سال 2000 شرکت 3dfx را خرید، این تکنولوژی را نیز تصاحب کرد. چند سال بعد، در سال 2004، انویدیا مفهوم SLI را با نام جدید Scalable Link Interface احیا کرد و AMD نیز در سال 2005 با تکنولوژی CrossFire به میدان آمد. ایده تجاری بسیار وسوسه‌انگیز بود: گیمرها می‌توانستند امروز یک کارت میان‌رده بخرند و سال آینده، وقتی قیمت آن افت کرد، کارت دوم را بخرند و با اتصال آن‌ها، عملکردی در حد یک پرچمدار گران‌قیمت داشته باشند. مجلات سخت‌افزاری پر شده بودند از عکس مادربردهایی که دو یا سه کارت گرافیک غول‌پیکر روی آن‌ها نصب شده بود و با پل‌های اتصال (SLI Bridge) به هم گره خورده بودند. این ترکیب، نماد نهایی ثروت و تخصص در دنیای PC بود. READ گوگل نسخه جدیدی از مرورگر کروم اندروید با پشتیبانی از افزونه‌ها را آزمایش می‌کند فصل دوم: عصر هیولاها؛ کالبدشکافی GTX 690 و R9 295X2 رقابت بر سر فریم‌ریت بالاتر، مهندسان را به جنون کشاند. اگر گیمرها نمی‌خواستند دو کارت گرافیک مجزا بخرند، چرا دو پردازنده گرافیکی (GPU) را روی یک برد مدار چاپی (PCB) لحیم نکنیم؟ اینجا بود که عصر کارت‌های گرافیک «دو هسته‌ای» (Dual-GPU) آغاز شد. در می سال 2012، انویدیا از شاهکار مهندسی خود رونمایی کرد: GeForce GTX 690. این کارت صرفاً یک قطعه سخت‌افزاری نبود، بلکه یک بیانیه هنری و صنعتی بود. انویدیا دو تراشه کامل GK104 (همان تراشه‌های استفاده شده در GTX 680) را روی یک برد قرار داد. طراحی ظاهری این کارت هوش از سر منتقدان پراند. محفظه خنک‌کننده از آلومینیوم با روکش کروم سه‌ظرفیتی و آلیاژ منیزیم قالب‌گیری شده ساخته شده بود (موادی که معمولاً در صنایع هوافضا استفاده می‌شوند). دو محفظه بخار (Vapor Chamber) اختصاصی و یک فن مرکزی وظیفه خنک کردن این کوره کوچک را بر عهده داشتند. اما این هیولای 999 دلاری، مصرف برق وحشتناکی داشت. توان حرارتی (TDP) آن 300 وات اعلام شده بود، اما در عمل و زیر فشار، کل سیستم به منبع تغذیه‌هایی (پاور) با توان 800 تا 1000 وات نیاز داشت. AMD نیز بی‌کار ننشست. آن‌ها در سال 2014 با معرفی Radeon R9 295X2 مرزهای دیوانگی را جابه‌جا کردند. این کارت چنان داغ و پرمصرف بود (با TDP خیره‌کننده 500 وات!) که خنک‌کننده بادی برای آن جوابگو نبود و AMD مجبور شد آن را به صورت پیش‌فرض با یک سیستم خنک‌کننده مایع (واترکولر) یکپارچه روانه بازار کند. این کارت‌ها شبیه به موتورهای V12 در دنیای ماشین‌ها بودند: پرمصرف، داغ، پر سروصدا، اما به شدت جذاب. فصل سوم: ترک‌های روی دیوار؛ چرا فیزیک و نرم‌افزار با هم درگیر شدند؟ در حالی که روی کاغذ همه چیز عالی به‌نظر می‌رسید، در دنیای واقعی، استفاده از دو GPU همزمان، یک کابوس تکنیکال بود. برای اینکه بفهمیم چرا این سیستم شکست خورد، باید تکنولوژی پشت آن را به زبان ساده کالبدشکافی کنیم. در سیستم‌های مدرن SLI و CrossFire، از روشی به نام AFR (Alternate Frame Rendering) استفاده می‌شد. یعنی کارت گرافیک شماره 1، فریم‌های فرد (فریم 1، 3، 5) را رندر می‌کرد و کارت گرافیک شماره 2، وظیفه رندر فریم‌های زوج (فریم 2، 4، 6) را بر عهده داشت. این روش در تئوری باید نرخ فریم را دقیقاً دو برابر (یعنی 100% افزایش) می‌کرد. اما واقعیت چیز دیگری بود. ۱. دروغی به نام حافظه دو برابر (VRAM Illusion): وقتی شما دو کارت گرافیک با 2 گیگابایت حافظه (VRAM) را به هم متصل می‌کردید، برخلاف تصور عموم، 4 گیگابایت حافظه نداشتید! در روش AFR، هر کارت باید یک کپی دقیق از تمام اطلاعات صحنه (تکسچرها، مدل‌ها و…) را در حافظه خود داشته باشد تا بتواند فریم خود را رندر کند. بنابراین حافظه‌ها با هم جمع نمی‌شدند، بلکه «آینه» (Mirror) یکدیگر بودند. شما همان 2 گیگابایت را داشتید، فقط دو بار! این موضوع در بازی‌های جدیدتر که به حافظه گرافیکی عظیمی نیاز داشتند، به شدت گلوگاه (Bottleneck) ایجاد می‌کرد. READ هواوی رئیس جمهور سابق برزیل را به عنوان مشاور شبکه 5G استخدام کرد۲. لکنت مایکرو (Micro-Stuttering)؛ وقتی فریم‌ریت بالا هم فایده ندارد: این مرگبارترین ضربه به پیکر SLI بود. فرض کنید نرم‌افزار نشان می‌دهد بازی با 60 فریم بر ثانیه اجرا می‌شود، اما بازی روی مانیتور به طرز عجیبی پرش دارد و روان نیست. چرا؟ به‌دلیل پدیده‌ای به نام Micro-Stuttering (لکنت ریز). در روش AFR، قرار است کارت اول فریم 1 را بدهد و بلافاصله کارت دوم فریم 2 را تحویل دهد. اما گاهی فریم کارت دوم کمی پیچیده‌تر بود و پردازش آن چند میلی‌ثانیه بیشتر طول می‌کشید. در نتیجه، فریم 1 نمایش داده می‌شد، سپس یک مکث بسیار ریز اتفاق می‌افتاد، و بعد فریم 2 و 3 پشت سر هم روی صفحه پرتاب می‌شدند. این عدم هماهنگی در زمان‌بندی فریم‌ها (Frame Pacing) باعث می‌شد که تجربه بصری کاربر، با وجود فریم‌ریت بالا در نرم‌افزارهای بنچمارک، بسیار آزاردهنده و غیرروان باشد. ۳. قانون بازده نزولی (Diminishing Returns): کارت دوم هرگز 100% افزایش کارایی نمی‌داد. در بهترین حالت این رقم بین 40% تا 70% بود. اضافه کردن کارت سوم این افزایش را به 15% و کارت چهارم گاهی عملکرد را کاهش می‌داد، زیرا پردازنده مرکزی (CPU) نمی‌توانست اطلاعات را با سرعت کافی بین چهار هیولای تشنه تقسیم کند و گلوگاه ایجاد می‌شد. فصل چهارم: کابوس توسعه‌دهندگان بازی و تغییر معماری رندرینگ مشکلات سخت‌افزاری تنها نیمی از داستان بود. قاتل اصلی SLI و CrossFire، موتورهای بازی‌سازی مدرن بودند. در گذشته، رندر کردن یک فریم، فرآیندی مستقل بود. اما با پیشرفت گرافیک، توسعه‌دهندگان به تکنیک‌های جدیدی مانند TAA (Anti-Aliasing موقت) روی آوردند. در این تکنیک‌ها، برای محاسبه نور یا لبه‌های تصویر در فریم فعلی (مثلاً فریم 2)، کارت گرافیک باید بداند که در فریم قبلی (فریم 1) چه اتفاقی افتاده است. اما به یاد بیاورید که در AFR، فریم 1 دست کارت اول و فریم 2 دست کارت دوم است! این دو کارت برای تبادل این اطلاعات سنگین از طریق پل SLI یا مادربرد، به زمان نیاز داشتند. این تاخیر، کل فلسفه سرعت را زیر سوال می‌برد. بهینه‌سازی بازی‌ها برای SLI به قدری سخت، پرهزینه و زمان‌بر بود که استودیوهای بازی‌سازی یکی پس از دیگری اعلام کردند: «ما دیگر از این تکنولوژی پشتیبانی نمی‌کنیم.» فصل پنجم: میخ آخر بر تابوت؛ DirectX 12 و تسلیم انویدیا در سال‌های 2015 به بعد، با معرفی رابط‌های برنامه‌نویسی جدید مانند DirectX 12 و Vulkan، تغییر بنیادی دیگری رخ داد. در گذشته، انویدیا و AMD از طریق آپدیت درایورهای خود، بازی‌ها را به زور با SLI سازگار می‌کردند. اما در DirectX 12، این مسئولیت به‌طور کامل به گردن توسعه‌دهنده بازی (Game Developer) افتاد (تکنیکی به نام Explicit Multi-Adapter). READ یک یوتوبر RTX 3060 را حین اجرای بازی با دستگاه یخ‌ساز تا ۲۱ درجه خنک کرد!همان‌طور که قابل پیش‌بینی بود، استودیوها که دیدند تنها کمتر از 1% گیمرها از سیستم‌های چند کارته استفاده می‌کنند، هیچ بودجه‌ای برای کدنویسی آن اختصاص ندادند. بازی‌ها یکی پس از دیگری بدون پشتیبانی از SLI و CrossFire منتشر شدند. انویدیا ابتدا پشتیبانی از سه و چهار کارت را متوقف کرد. سپس پل‌های پهن‌تر و گران‌تری (مانند NVLink) معرفی کرد تا شاید مشکل تاخیر را حل کند، اما دیگر دیر شده بود. سرانجام در سری RTX 3000، انویدیا رسماً اعلام کرد که پشتیبانی از SLI را به پایان رسانده است. در نسل RTX 4000، حتی پین‌های اتصال NVLink نیز از روی کارت‌های گیمینگ حذف شدند. ای‌ام‌دی نیز در سکوت کامل، برند CrossFire را به خاک سپرد. تایتان‌ها سقوط کرده بودند. جمع‌بندی: مرثیه‌ای برای هیولاهای پرمصرف مرگ SLI و CrossFire یک تراژدی نبود، بلکه یک تکامل ضروری بود. در حالی که ما رویای ترکیب کارت‌ها را در سر می‌پروراندیم، قانون مور و پیشرفت‌های معماری سیلیکون کار خود را می‌کردند. مهندسان متوجه شدند که به جای درگیر شدن با مشکلات هماهنگی دو تراشه، بهتر است یک تراشه واحد بسیار بزرگ و قدرتمند بسازند. کارت‌هایی مانند GTX 690 امروزه به‌عنوان اشیای کلکسیونی و نمادهای دوره «غرب وحشی» در سخت‌افزار کامپیوتر شناخته می‌شوند؛ دوره‌ای که شرکت‌ها برای کسب تاج پادشاهی، حاضر بودند قوانین فیزیک، مصرف انرژی و جیب مصرف‌کننده را به چالش بکشند. امروزه، پردازش چندگانه گرافیکی فقط در دیتاسنترها و برای هوش مصنوعی (AI) استفاده می‌شود، جایی که هزاران کارت گرافیک بدون نیاز به رندر کردن تصویر برای مانیتور، اعداد را پردازش می‌کنند. رویای گیمینگ با چند کارت گرافیک مرده است، اما میراث آن دوران یعنی عطش سیری‌ناپذیر برای گرافیک واقع‌گرایانه‌تر هنوز هم در قلب هیولاهای تک‌هسته‌ای و مدرن امروزی می‌تپد. دفعه بعد که کارت گرافیک جدید و ضخیم خود را درون کیس نصب می‌کنید، به یاد داشته باشید که این هیولای یکپارچه، روی استخوان‌های اجداد دوگانه‌اش ایستاده است.

مدیر 3 ماه قبل
کالا هایی که دیده ایید !
شما این محصولات را انتخاب کرده اید0
empty-cart

هیچ محصولی در سبد خرید نیست.

جهت مشاهده محصولات بیشتر به صفحات زیر مراجعه نمایید.
کامپیوتر همه کاره 18.5 اینچ مدل PC185I52B

حسین نیکوکار

کامپیوتر همه کاره 18.5 اینچ مدل PC185I52B
9 روز پیش خریداری شدهتایید شده