برچسب: کامپیوتر و سخت افزار

1 دقیقه زمان مطالعه

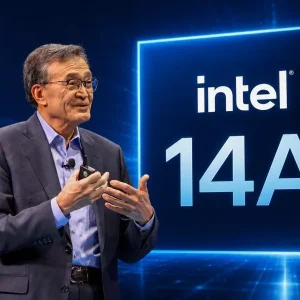
فناوری Intel 14A اینتل در سال ۲۰۲۸ به تولید انبوه می‌رسد

فناوری Intel 14A اینتل در سال ۲۰۲۸ به تولید انبوه می‌رسد اینتل تأیید کرده است که فناوری فرآیندی 14A این شرکت اکنون در سال ۲۰۲۸ وارد مرحله تولید انبوه خواهد شد و «لیپ-بو تن» (Lip-Bu Tan)، مدیرعامل اینتل، نسبت به توانایی این گره در ارائه توان، تراکم، هزینه و زمان‌بندی رقابتی ابراز اطمینان کرد. اینتل گزارش مالی قدرتمند دیگری را منتشر کرد و تقاضای بالا را به‌عنوان محرک اصلی درآمد خود برجسته ساخت. در جریان کنفرانس گزارش درآمد، لیپ-بو تن، مدیرعامل اینتل، به‌روزرسانی پیشرفت‌های بخش فاندری (Intel Foundry) را ارائه داد. «اجرای منظم» (Disciplined Execution) اینتل و اعتماد فزاینده ناشی از طراحی محصولات داخلی و مشتریان خارجی، اینتل فاندری را به یک سازنده نیمه‌هادی رقابتی تبدیل کرده است. اینتل در سه ماهه دوم گزارش داد که فناوری‌های فرآیندی Intel 7 ،Intel 3 و Intel 18A از اهداف حجم داخلی خود فراتر رفته‌اند. این حجم به لطف بهبود بهره‌وری، زمان چرخه‌های بهتر و افزایش ذخایر ویفر حاصل شده است. به ویژه گره 18A شاهد افزایش خروجی بوده است که به تولید انبوه‌ محصولات مبتنی‌بر 18A مانند پنتر لیک با نام «Core Ultra Series 3» و وایلدکت لیک با نام «Core Series 3» کمک خواهد کرد. لیپ-بو اظهار داشت که او «به‌طور مداوم استانداردهای اهداف داخلی را بالاتر می‌برد» و تیم او همچنان به چالش‌های پیش‌روی خود پاسخ می‌دهند. اینتل همچنین تولید آزمایشی (Risk Production) گره 18A-P را آغاز کرده است، اما با گذر به گره 14A، این فناوری در هر دو شاخص چگالی نقص و عملکرد ترانزیستور از 18A پیشی گرفته است. اینتل درحال‌حاضر کیت توسعه پکیج (PDK 0.5) را ارائه کرده و PDK 0.9 طبق برنامه برای اکتبر سال جاری میلادی آماده می‌شود. اینتل به توسعه و اعتبارسنجی سبد مالکیت معنوی (IP) برای 14A ادامه می‌دهد، چرا که این فناوری «در طیف وسیعی از مشتریان» اتخاذ خواهد شد. لیپ-بو از روند رو به رشد تعامل با مشتریان برای 14A خرسند است و آن‌ها همچنین روی استفاده چندین محصول داخلی از این فناوری تمرکز کرده‌اند. براساس آخرین جدول زمانی، 14A برای تولید آزمایشی محصولات داخلی در نیمه دوم سال ۲۰۲۷ (که پیش‌تر ۲۰۲۸ بود) در مسیر درستی قرار دارد و تولید انبوه آن برای سال ۲۰۲۸ (جلوتر از برنامه‌های اولیه سال ۲۰۲۹) پیش‌بینی می‌شود. READ اینستاگرام به افکت‌های صوتی جدید مجهز شد؛ خوشحالی گل به مناسبت جام جهانیلیپ-بو تن، مدیرعامل اینتل، در این باره گفت: «من از مشاهده روند رو به رشد تعامل با مشتریان برای Intel 14A خرسندم و روزبه‌روز مطمئن‌تر می‌شوم که 14A یک فرآیند بسیار رقابتی در بخش‌های کلیدی عملکرد، توان، تراکم، هزینه و زمان‌بندی خواهد بود. ما پیشرفت مشتریان خارجی و افزایش تقاضا برای محصولات داخلی خود را تشویق می‌کنیم. ما در مسیر تولید آزمایشی 14A برای محصولات داخلی خود در نیمه دوم سال ۲۰۲۷ قرار داریم و در سه ماهه دوم تصمیم گرفتیم که کاملاً متعهد به افزایش تولید انبوه در سال ۲۰۲۸ شویم.» برنامه‌های تولید انبوه (HVM) برای گره 14A نشان می‌دهد که مشتریان واقعاً مشتاقند تا در اسرع وقت از این فناوری استفاده کنند و انتظار می‌رود اینتل محصولات خود را روی این فناوری عرضه کند تا پتانسیل این گره را به شرکای خود نشان دهد. تاکنون چندین توافق همکاری برای 14A گزارش شده است، اما نام‌های بزرگ هنوز پنهان مانده‌اند و مشتریان لیپ-بو منتظر لحظه مناسب هستند تا فاش کنند که درحال ساخت جدیدترین و بهترین تراشه‌های خود در اینتل فوندری هستند.

مدیر 3 ماه قبل
2 دقیقه زمان مطالعه

پردازنده‌های EPYC Venice پیش‌نمایشی از قدرت پردازنده‌های رایزن آینده ارائه می‌دهند

پردازنده‌های EPYC Venice پیش‌نمایشی از قدرت پردازنده‌های رایزن آینده ارائه می‌دهند شرکت AMD اولین پردازنده‌های Zen 6 خود یعنی EPYC Venice را عرضه کرده است و ما از آن‌ها برای تحلیل انتظارات خود از خط تولید رایزن «Olympic Ridge» استفاده می‌کنیم. تعجب‌آور است که چگونه AMD استراتژی خود را در طول سال‌ها تکامل داده است. هنگامی که اولین معماری Zen راه‌اندازی شد، ابتدا برای کامپیوترهای شخصی دسکتاپ منتشر شد. خانواده نسل اول EPYC با نام رمز Naples، تا چند ماه بعد از آن عرضه نشد. این روند تابه‌امروز برای تمام عرضه‌های Zen صادق بوده است: رایزن ابتدا عرضه می‌شود و پس از آن EPYC می‌آید، اما با Zen 6 این رویه تغییر کرده است. خانواده EPYC Venice مبتنی‌بر Zen 6 عرضه شده است و خانواده رایزن چند ماه بعد در اوایل سال ۲۰۲۷ عرضه خواهد شد. می‌توانید فکر کنید که هوش مصنوعی عامل اصلی این تصمیم توسط AMD بوده است. ما دیده‌ایم که تقاضا برای پردازش چقدر زیاد است و همچنین دیده‌ایم که بخش کامپیوترهای شخصی به‌دلیل افزایش قیمت قطعات و کمبودهای شدید در تمام بخش‌ها، درحال‌حاضر در بهترین شرایط خود قرار ندارد. بنابراین تصمیم AMD تا حدودی منطقی به نظر می‌رسد، اما با وجود تمام این موارد، پردازنده‌های دسکتاپ رایزن همچنان یک بازار حیاتی برای این سازنده تراشه باقی می‌مانند و طرفداران زیادی منتظرند تا ببینند AMD چه چیزی با خط تولید نسل بعدی برای آن‌ها در چنته دارد. ما برخی از جنبه‌های پردازنده‌های نسل بعدی رایزن را به تفصیل بررسی کرده‌ایم، اما خط تولید EPYC با معماری Zen 6 سرنخ‌های بیشتری را در مورد اینکه رایزن در ادامه به کجا خواهد رفت، به ما می‌دهد. معماری Zen 6 هسته‌های بیشتری را به همراه دارد اولین جزئیاتی که اکنون می‌توانیم تأیید کنیم این است که معماری Zen 6 شرکت AMD دارای هسته‌ها و رشته‌های بیشتری خواهد بود. از زمان Zen 1 و Zen 2، خانواده رایزن در حداکثر ۸ هسته و ۱۶ رشته باقی مانده بود. هر یک از این معماری‌های Zen دارای یک CCD (دای هسته محاسباتی) منفرد بودند که شامل دو CCX (مجموعه هسته محاسباتی) بود. دو نسل اول دارای ۱۶ مگابایت کش L2 اختصاصی برای هر CCX بودند، بنابراین درحالی‌که این CCXها روی یک CCD قرار داشتند، دارای «LLC مشترک» واقعی نبودند. این وضعیت با نسل‌های Zen 4 ،Zen 3 و Zen 5 تغییر کرد؛ نسلی که به طراحی مدرن CCD منتقل شد که کامل‌تر بود و تا ۱۶ هسته با ۳۲ رشته را در خود جای می‌داد. هر یک از این موارد دارای ۸ هسته به ازای هر CCD بودند و از آنجایی که CCX خود به CCD تبدیل شد، به این معنی بود که کل کش ۳۲ مگابایتی اکنون می‌تواند در سراسر تراشه‌ها به اشتراک گذاشته شود. بنابراین شما از ۸ هسته به ۱۶ هسته و از ۱۶ مگابایت کش به ۳۲ مگابایت کش رسیدید (رایزن‌های پیش از Zen 3 دارای ۱ CCD با دو CCX شانزده مگابایتی بودند، درحالی‌که Zen 3 و بالاتر دارای دو CCD با ۳۲ مگابایت به ازای هر دای هستند). اما ما سه نسل از Zen را بدون هیچ‌گونه افزایش چشمگیر در تعداد هسته یا کش پشت سر گذاشته‌ایم. گزینه‌های 3D V-Cache کش بیشتری را به ارمغان آوردند، اما پیکربندی هسته راکد مانده بود. اکنون با Zen 6، شاهد یک تغییر بزرگ خواهیم بود. بار دیگر، AMD همان ساختار دو CCD و یک IOD را برای پردازنده‌های رایزن مبتنی‌بر Zen 6 حفظ خواهد کرد. READ اطلاعات جدیدی درباره کارت گرافیک AMD رادئون 9060 XT فاش شد اول از همه، AMD تأیید کرده است که Zen 6 دارای دو نسخه خواهد بود: Zen 6 با ۱۲ هسته به ازای هر دای و Zen 6C با ۱۶ هسته به ازای هر دای. نسخه Zen 6C انحصاری بخش سازمانی و HPC خواهد بود، بنابراین این امر ۱۲ هسته به ازای هر دای را به ما می‌دهد. و پردازنده پایه EPYC 9016 که یک تراشه ۸ هسته‌ای است، تأیید می‌کند که Zen 6 دارای ۴۸ مگابایت کش به ازای هر CCD است. بنابراین علاوه‌بر افزایش ۵۰ درصدی در تعداد هسته‌ها، Zen 6 همچنین ۵۰ درصد افزایش کش را دریافت می‌کند. دو CCD مجهز به Zen 6 به این معنی است که پرچمدار پردازنده‌های دسکتاپ رایزن «Olympic Ridge» تا ۲۴ هسته، ۴۸ رشته و ۹۶ مگابایت کش L3 را ارائه خواهد داد، درحالی‌که نسخه تک CCD تا ۱۲ هسته، ۲۴ رشته و ۴۸ مگابایت کش L3 را ارائه می‌کند. EPYC 9006Base / BoostEPYC 9005Base / BoostBase UpliftBoost UpliftEPYC 90163.05 / 4.80EPYC 90153.60 / 4.100.847x1.170xEPYC 91162.85 / 4.50EPYC 91152.60 / 4.101.096x1.097xEPYC 9176F3.90 / 5.00EPYC 9175F4.20 / 4.550.928x1.098xEPYC 9276F3.80 / 5.00EPYC 9275F4.10 / 4.500.926x1.111xEPYC 93363.15 / 3.70EPYC 93353.00 / 4.401.050x0.840xEPYC 93563.60 / 4.50EPYC 93553.55 / 4.401.014x1.022xEPYC 9376F3.80 / 5.00EPYC 9375F3.80 / 4.401.000x1.136xEPYC 96462.80 / 3.70EPYC 94553.15 / 4.400.888x0.840xEPYC 9476F3.65 / 5.00EPYC 9475F3.65 / 4.801.000x1.041xEPYC 95363.25 / 4.00EPYC 95352.40 / 4.301.354x0.930xEPYC 9576F3.55 / 5.00EPYC 9575F3.30 / 5.001.060x1.000xEPYC 97462.90 / 4.00EPYC 97452.40 / 3.451.208x1.159xAverages1.031x1.037x بنابراین اگر Zen 6 را با Zen 5 مقایسه کنیم، به موارد زیر دست خواهیم یافت: ۵۰ درصد هسته‌های بیشتر ۵۰ درصد رشته‌های بیشتر ۵۰ درصد کش بیشتر براساس جزئیات قبلی، پیش‌بینی می‌شود که پردازنده‌های رایزن «Olympic Ridge» در چندین مدل با تعداد هسته‌ها و کش‌های مختلف مقیاس‌پذیر باشند: Zen 6 (تک CCD) - ۶ هسته Zen 6 (تک CCD) - ۸ هسته Zen 6 (تک CCD) - ۱۰ هسته Zen 6 (تک CCD) - ۱۲ هسته Zen 6 (دوال CCD) - ۱۶ هسته (۸+۸) Zen 6 (دوال CCD) - ۲۰ هسته (۱۰+۱۰) Zen 6 (دوال CCD) - ۲۴ هسته (۱۲+۱۲) افزایش فرکانس هسته‌ها اکنون در مورد سرعت‌های کلاک، انتظار می‌رود پردازنده‌های Zen 6 شرکت AMD سقف فرکانس را بیشتر افزایش دهند و این موضوع را هم‌اکنون می‌توان در بسیاری از پردازنده‌های نسل ششم EPYC مشاهده کرد. پردازنده‌های استاندارد Zen 6 تا ۵.۰۰ گیگاهرتز فرکانس دارند و مدل‌های آینده مجهز به V-Cache دارای کلاک ۵.۱۵ گیگاهرتز خواهند بود. اکنون مقایسه با پردازنده‌های EPYC ساده نیست، زیرا تراشه‌های سرور دارای پروفایل‌های توان سخت‌گیرانه‌تری هستند و با در نظر گرفتن پایداری و دوام طراحی شده‌اند. پردازنده‌های دسکتاپ فرکانس‌های بسیار بالاتری دارند زیرا در زمینه فرکانس، توان (TDP/PPT)، پلتفرم و خود تراشه که آن بودجه توانی را با دای‌های عظیم I/O به اشتراک می‌گذارد، انعطاف‌پذیرتر هستند. بنابراین ما بهبودهای نسلی Zen 6 مدل «EPYC» را با Zen 5 مدل «EPYC» مقایسه می‌کنیم. بیشترین فرکانس پایه برای Zen 6 EPYC روی ۳.۹۰ گیگاهرتز ارزیابی شده است، درحالی‌که بیشترین فرکانس پایه برای Zen 5 EPYC روی ۳.۸۰ گیگاهرتز قرار دارد. فرکانس‌های بوست برای Zen 5 تا ۵.۰ گیگاهرتز می‌روند و همین موضوع برای Zen 6 نیز صادق است، اما این وضعیت اوایل سال آینده با آمدن تراشه‌های بهینه‌تر با کلاک ۵.۱۵ گیگاهرتزی تغییر خواهد کرد. READ AMD از تراشه‌های Ryzen AI Max برای کامپیوترهای هوش مصنوعی پرده برداشتبه‌طور متوسط، با مقایسه مدل‌هایی با تعداد هسته یکسان، می‌توانیم شاهد افزایش ۳.۱ درصدی در کلاک پایه و ۳.۷ درصدی در کلاک بوست باشیم. حتی با یک مدل ۵.۱۵ گیگاهرتزی Zen 6، پروفایل بوست تنها ۳ درصد افزایش یافته است که با بقیه تراشه‌ها همخوانی دارد. اگر میانگین‌ها را روی سریع‌ترین تراشه در پشته رایزن ۹۰۰۰ اعمال کنیم، از ۵.۷ گیگاهرتز به کمی کمتر از ۶.۰ گیگاهرتز می‌رسیم. اما بیایید کار دیگری انجام دهیم و حداکثر افزایش بوستی را که هر پیکربندی هسته تا ۲۴ هسته ارائه می‌دهد، اعمال کنیم. مدل ۸ هسته‌ای افزایشی ۱۷ درصدی را تجربه می‌کند که اگر روی یک پردازنده موجود AMD رایزن 7 9850X3D اعمال شود، سرعت کلاک را فراتر از ۶.۵ گیگاهرتز (از ۵.۶ گیگاهرتز) هل می‌دهد. مدل ۱۶ هسته‌ای از ۵.۶/۵.۷ گیگاهرتز به ۶.۱/۶.۲ گیگاهرتز می‌رسد (با اعمال ضریب بوست ۱.۰۹۷ برابری EPYC 9116) و برای مدل‌های ۲۴ هسته‌ای، حداکثر افزایش بوست ۱.۱۱ برابری باید فرکانس‌های بوست را تا ۶.۲ الی ۶.۳ گیگاهرتز افزایش دهد. نکته کوتاه - پردازنده AMD EPYC Venice (مبتنی‌بر کلاسیک Zen 6) روی گره N2P ساخته شده است، درحالی‌که EPYC Turin (مبتنی‌بر کلاسیک Zen 5) روی گره N4X ساخته شده است. برای رایزن، نسخه Olympic Ridge (کلاسیک Zen 6) از همان گره پردازشی N2P بهره خواهد برد، درحالی‌که پردازنده‌های موجود Granite Ridge (کلاسیک Zen 5) دارای گره N4P هستند. گره N4X عملکردی ۴ درصدی نسبت به N4P ارائه می‌دهد. بنابراین خود گره پردازشی می‌تواند یک بوست اضافی در فرکانس ایجاد کند. این درصورتی است که AMD تنها به‌دنبال سرعت کلاک باشد. اگر توان به جنبه‌های دیگر تراشه اختصاص یابد، می‌توانیم شاهد یک پایه استاندارد در حدود ۶ تا ۶.۲ گیگاهرتز باشیم که باید رایزن Zen 6 را در همان دسته تراشه‌های Raptor Lake Refresh اینتل قرار دهد که درحال‌حاضر بالاترین سرعت‌های کلاک را در دسکتاپ‌ها ارائه می‌دهند. اینتل سرعت کلاک خود را با Arrow Lake کاهش داد، بنابراین ما امیدواریم ارقام مناسبی را در خطوط تولید نسل بعدی ببینیم. 5th Gen SKUTDP6th Gen SKUDefault CPU PowerDifference9745400W9746400W0%9645320W9646300W−6.3%9575F400W9576F400W0%9535300W9536300W0%9475F400W9476F330W−17.5%9455300W9456265W−11.7%9375F320W9376F285W−10.9%9355280W9356250W−10.7%9335210W9336195W−7.1%9275F320W9276F230W−28.1%9255200W9256190W−5%9175F320W9176F200W−37.5%9015125W9016130W+4%Average Power اکنون در مورد مصرف انرژی، بار دیگر این واقعیت که EPYC به‌طور کلی بسیار بزرگ‌تر است و دارای دو دای I/O غول‌پیکر است به این معنی است که ویژگی‌های توانی آن همیشه بالاتر از یک تراشه استاندارد دسکتاپ خواهد بود، اما تفاوت‌هایی نیز از نظر مدیریت توان وجود دارد. سرورها و پردازنده‌های مربوط به آن‌ها به شدت به قابلیت‌های سریع و غنی I/O متکی هستند، به همین دلیل است که دای‌های I/O بزرگ هستند، درست مانند تراشه‌های EPYC. بنابراین I/O بیشتر، چیپلت‌های بیشتر، توان مصرفی بیشتر. در دسکتاپ‌ها، این توان در تعداد کمتری از چیپلت‌ها مدیریت می‌شود، به این معنی که محدوده توانی بیشتری در دسترس CCDها قرار دارد. در نتیجه، تراشه‌ها می‌توانند فرکانس‌های بالاتری تولید کنند یا آن توان را با بهره‌وری اضافی معامله کنند. تعادل باید برقرار باشد، اما تراشه‌های دسکتاپ و علاقه‌مندان اغلب تمام توان موجود را استخراج می‌کنند. READ انتشار امواج وای فای در یک آپارتمان چگونه است و چگونه می توان نقاط کور را در خانه پیدا کرد؟گذر به گره ۲ نانومتری TSMC همچنین بهبودهای خوبی را به همراه دارد. از Zen 5 روی گره ۳ نانومتری TSMC تا Zen 6 روی ۲ نانومتری، اعداد توان مصرفی کاهش چشمگیری را برای هر مدل تحت تعداد هسته یکسان نشان می‌دهند. در تمامی مدل‌ها، شاهد کاهش متوسط ۱۰ درصدی در مصرف انرژی هستیم. تنها یک مدل، یعنی مدل ۸ هسته‌ای، افزایش ۴ درصدی در توان را تجربه می‌کند. این نشان می‌دهد که Zen 6 به طور کلی در مصرف توان پایین‌تر اما در تمام بردارهای عملکردی بالاتر است. بنابراین در حالی که این به معنای کاهش اعداد توان مصرفی در پردازنده‌های رایزن «Olympic Ridge» شرکت AMD نیست، اما به این معناست که Zen 6 فضای توانی اضافی را برای هدایت به سمت هسته‌ها فراهم می‌کند که می‌تواند به فرکانس‌ها یا عملکرد بیشتری منجر شود. تا ۹۶ مگابایت حافظه پنهان LLC بدون 3D V-Cache و نسخه بزرگ‌تر آن اکنون در مورد حافظه پنهان (Cache)، اشاره کردیم که چگونه این مقدار ۵۰ درصد بهبود یافته و به ۴۸ مگابایت به ازای هر CCD رسیده است. این مقدار روی یک مدل دو CCD به ۹۶ مگابایت می‌رسد که دقیقاً همان مقدار کش سری پردازنده‌های ۸ هسته‌ای 3D V-Cache است...

مدیر 3 ماه قبل
1 دقیقه زمان مطالعه

رونمایی از نقشه راه AMD با معماری‌های Zen 7 و Zen 8

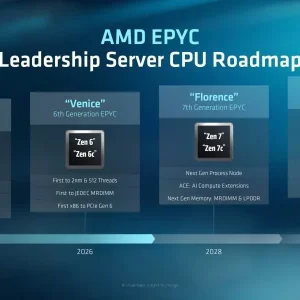
رونمایی از نقشه راه AMD با معماری‌های Zen 7 و Zen 8 شرکت AMD به‌طور رسمی از معماری‌های پردازنده نسل بعدی خود یعنی Zen 7 و Zen 8 رونمایی کرد که قرار است در تراشه‌های سرور EPYC Florence و EPYC Ravenna مورد استفاده قرار بگیرند. شرکت AMD به‌تازگی اولین تراشه‌های EPYC خود را براساس معماری هسته Zen 6 معرفی کرده است و در رویداد Advancing AI 2026، نگاهی اجمالی از آینده به ما ارائه می‌دهد که شامل دو معماری کاملاً جدید پردازنده یعنی Zen 7 و Zen 8 می‌شود. همان‌طور که در پیش‌نمایش رویداد پیش‌بینی کرده بودیم، لیزا سو، مدیرعامل ای‌ام‌دی، با معرفی این محصولات به پایانی شکوهمند برای رویدادی دست یافت که طیف وسیعی از پیشرفت‌های هوش مصنوعی، از پردازنده‌های مرکزی و گرافیکی گرفته تا رک‌ها و پشته‌های نرم‌افزاری را پوشش می‌داد. بزرگ‌ترین غافلگیری این رویداد، اعلام معماری‌های پردازنده نسل بعدی با نام‌های رمز Zen 7 و Zen 8 بود. معماری Zen 7؛ میزبان اولین پردازنده‌های EPYC با پشتیبانی از ACE به گفته AMD، معماری پردازنده Zen 7 برای بازه زمانی سال ۲۰۲۸ هدف‌گذاری شده و توسط خانواده نسل هفتم EPYC با نام رمز «Florence» اتخاذ خواهد شد. درست مانند نسخه‌های قبلی Zen، معماری Zen 7 در مدل‌های کلاسیک و بهینه‌شده برای محاسبات (Zen 7C) عرضه خواهد شد. نکته قابل‌توجه درباره Zen 7 این است که این تراشه‌ها روی یک گره پردازشی نسل بعدی ساخته خواهند شد، بنابراین می‌توانیم انتظار فناوری‌هایی در رده زیر ۲ نانومتر، مانند گره‌های A16 یا A14 شرکت TSMC را داشته باشیم. این پردازنده‌ها همچنین اولین خانواده EPYC خواهند بود که از استانداردهای حافظه نسل بعدی یعنی MRDIMM و سری LPDDR پشتیبانی می‌کنند. این تراشه‌ها روی پلتفرم‌های موجود SP7 و SP8 پشتیبانی خواهند شد؛ مدل‌های SP7 تعداد هسته و عملکرد پیشتازی را ارائه می‌دهند، درحالی‌که تراشه‌های SP8 روی بهینه‌سازی عملکرد به ازای هر سیستم و هزینه تمرکز دارند. علاوه‌براین، پردازنده‌های EPYC Florence به‌عنوان پردازنده میزبان برای راه‌حل رک هوش مصنوعی نسل بعدی AMD با نام رمز «Ferrara» عمل خواهند کرد. شرکت AMD همچنین درحال توسعه یک «سندباکس» عامل‌محور (Agentic Sandbox) براساس سیستم‌های هوش مصنوعی Ferrara به نام «Fidenza» است که استقرار مقیاس‌پذیر هوش مصنوعی را در قالب یک راهکار بهینه‌شده از نظر مصرف انرژی و عملکرد ارائه می‌دهد. READ AMD از تراشه‌های هوش مصنوعی سری رایزن پرو 8040 لپ‌تاپ و 8000 دسکتاپ رونمایی کردبااین‌حال، رک Ferrara جایگزین مدل Helios نخواهد شد، چرا که AMD قرار است در سال ۲۰۲۷ یک نسخه به‌روزرسانی‌شده از راه‌حل رک‌اسکیل Helios 500 را با بهره‌گیری از پردازنده‌های EPYC Verano، پردازنده‌های گرافیکی Instinct MI500 و تراشه‌های Pensando با نام‌های Como و Monza عرضه کند. مهم‌تر از آن، ای‌ام‌دی پردازنده‌های EPYC مبتنی‌بر Zen 7 را به‌عنوان نخستین خانواده EPYC معرفی می‌کند که از فناوری ACE مخفف «AI Compute Extensions» پشتیبانی می‌کنند. این افزونه‌ها بخشی از اتحاد x86 EAG (مشارکت مشترک اینتل و ای‌ام‌دی برای تقویت اکوسیستم x86) هستند و وظیفه آن‌ها ارائه قابلیت‌های استانداردسازی شده شتاب‌دهی ماتریسی در سرتاسر اکوسیستم x86 است. خانواده MI500 با حافظه HBM4e و طراحی‌های نوری؛ ورود سری MI600 به رک Ferrara در سال ۲۰۲۸ شرکت AMD همچنین به‌روزرسانی‌هایی را درباره نقشه راه پردازنده‌های گرافیکی Instinct خود ارائه داد. سری MI500 آماده است تا در سال ۲۰۲۷ عرضه شود و معماری CDNA 6، نسل بعدی حافظه HBM4e، دامنه مقیاس‌پذیری پیشتاز گرافیکی و طراحی‌های سازگار با مس و اپتیک را به ارمغان بیاورد. این تراشه‌ها به رقابت با پردازنده‌های گرافیکی Rubin Ultra انویدیا که در رک‌های Kyber به کار خواهند رفت، خواهند پرداخت. این شرکت همچنین روی معماری CDNA-Next برای سری MI600 کار می‌کند که عرضه آن برای سال ۲۰۲۸ هدف‌گذاری شده و باید با تراشه‌های Feynman انویدیا رقابت کند. سری MI600 در راهکارهای رک‌اسکیل هوش مصنوعی Helios 600 به همراه پردازنده‌های EPYC Ferrara و تراشه‌های Pensando (Palma / Levanzo) یکپارچه خواهد شد. توسعه زودهنگام نسل بعدی؛ معماری Zen 8 هم‌اکنون در حال ساخت است نسخه پس از Zen 7 با نام Zen 8 شناخته می‌شود و برای تأمین قدرت نسل هشتم خانواده پردازنده‌های EPYC AMD با نام رمز «Ravenna» مورد استفاده قرار خواهد گرفت. معماری Zen 8 و اولین تراشه‌های مبتنی‌بر آن هم‌اکنون درحال توسعه هستند که نشان می‌دهد ای‌ام‌دی نه تنها نقشه‌های راه خود را برای پاسخگویی به تقاضای فزاینده هوش مصنوعی تسریع کرده، بلکه درحال ساخت یک نقشه راه گسترده با تراشه‌هایی مجهز به فناوری‌های نسل بعد، عملکرد بهبودیافته، بهره‌وری بالا و ویژگی‌های پیشرفته است که آن را به‌عنوان یک رهبر در صنعت تراشه‌سازی تثبیت می‌کند. READ پلی استیشن 5 به احتمال قوی در سال 2020 عرضه می شود

مدیر 3 ماه قبل
1 دقیقه زمان مطالعه

AMD قیمت Helios را ۴۰ درصد گران‌تر از نسل دوم Rubin انویدیا تعیین می‌کند

AMD قیمت Helios را ۴۰ درصد گران‌تر از نسل دوم Rubin انویدیا تعیین می‌کند به نظر می‌رسد شرکت AMD دیگر از اینکه به عنوان یک بازنده همیشگی در بازار شناخته شود راضی نیست و گزارش‌ها حاکی از آن است که تصمیم گرفته با قیمت‌گذاری سیستم جدید «Helios» با قیمتی بسیار بالاتر نسبت به پلتفرم Rubin انویدیا، بیانیه‌ای شجاعانه صادر کند. علاوه‌براین، گزارش شده است که AMD موفق شده مایکروسافت را به عنوان اولین مشتری تأییدشده این محصول جذب کند که این امر کارایی و ارزش پیشنهادی Helios را حتی در سطح قیمت بالای آن به نمایش می‌گذارد. سیستم Helios اولین راه‌حل جامع در سطح رک از سوی شرکت AMD برای بارهای کاری هوش مصنوعی است که شامل اجزای زیر می‌شود: برای آگاهی کسانی که ممکن است مطلع نباشند، پردازشگرهای گرافیکی سری MI400 شرکت AMD از معماری جدید CDNA 5 بهره می‌برند و دارای ظرفیت و پهنای باند حافظه HBM4 افزایش‌یافته هستند. این پردازنده‌ها از فرمت‌های هوش مصنوعی توسعه‌یافته با توان عملیاتی بالاتر پشتیبانی می‌کنند. پردازشگر گرافیکی AMD Instinct MI455X که رک Helios را تغذیه می‌کند، توان پردازشی ۴۰ پتافلاپس در محاسبات FP4 و ۲۰ پتافلاپس در محاسبات FP8 ارائه می‌دهد. برای مقایسه، پردازشگر گرافیکی NVIDIA Rubin توان ۵۰ پتافلاپس در FP4 و تنها ۱۷.۵ پتافلاپس در محاسبات FP8 فراهم می‌کند. همچنین، پردازشگر گرافیکی MI455X از ۴۳۲ گیگابایت حافظه HBM4 با پهنای باند ۱۹.۶ ترابایت‌برثانیه استفاده می‌کند، درحالی‌که مدل Rubin انویدیا دارای ۲۸۸ گیگابایت حافظه HBM4 با پهنای باند ۲۲ ترابایت‌برثانیه است. در مرحله بعد، پردازنده مرکزی نسل ششم AMD EPYC با نام رمز «Venice»، بر اساس معماری هسته جدید Zen 6 و با استفاده از گره ۲ نانومتری TSMC ساخته شده است. این پردازنده‌ها تا ۲۵۶ هسته و ۵۱۲ رشته را با ۸ دای محاسباتی عظیم و ۲ دای ورودی/خروجی بزرگ‌تر ارائه می‌دهند. READ وزیر ارتباطات: تکمیل شبکه ملی اطلاعات در گرو همکاری اپراتورهاستکارت شبکه هوش مصنوعی AMD Pensando Vulcano 800 یک سوئیچ شبکه با عملکرد بالا و سرعت ۸۰۰ گیگابیت‌برثانیه است که توان عملیاتی شبکه اترنت ۸۰۰ گیگابیت‌برثانیه دارد. این کارت درحال‌حاضر تنها NIC است که تا ۲.۴ ترابایت‌برثانیه پهنای باند مقیاس‌پذیر به ازای هر پردازشگر گرافیکی با پشتیبانی کامل از برنامه‌نویسی سخت‌افزاری و نرم‌افزاری ارائه می‌دهد. در نهایت، DPU یا واحد پردازش داده Pensando سرورهای هوش مصنوعی را به شبکه‌های سازمانی متصل می‌کند و با بهبود فرآیندهای Offload شبکه، کارایی سرور هوش مصنوعی را افزایش می‌دهد؛ به طوری که هر DPU مدل Salina دارای ۱۶ هسته Arm N1 است که برای مدیریت شبکه، امنیت و ذخیره‌سازی در ارتباطات فرانت‌اند سرور به کلاینت استفاده می‌شوند. به گفته شرکت Futurum Group، شرکت AMD احتمالاً قیمت رک Helios را بین ۵ تا ۵.۵ میلیون دلار تعیین خواهد کرد که این رقم نمایانگر افزایش قیمت حدوداً ۴۰ درصدی نسبت به قیمت پیش‌بینی‌شده ۳.۵ تا ۴ میلیون دلاری برای نسل دوم رک Rubin انویدیا است. با این وجود، به خوانندگان توصیه می‌کنیم که این برآوردها را با احتیاط در نظر بگیرند؛ زیرا تخمین‌های هزینه مواد اولیه (BOM) همیشه دقیق نیستند و پویایی‌های قیمت‌گذاری رقابتی را نادیده می‌گیرند. در نهایت، مایکروسافت موافقت خود را برای استقرار رک Helios در سرویس‌های هوش مصنوعی Azure اعلام کرده است. علاوه‌براین، AMD درحال جذب شرکت‌های OpenAI، متا، اوراکل، HPE ،TCS، سلستیکا (Celestica)، نوتانیکس (Nutanix) و وزارت انرژی ایالات متحده (US DOE) به عنوان مشتریان خود است.

مدیر 3 ماه قبل
1 دقیقه زمان مطالعه

تراشه RTX Spark در دو نسخه با تعداد هسته‌های CUDA متفاوت عرضه می‌شود

تراشه RTX Spark در دو نسخه با تعداد هسته‌های CUDA متفاوت عرضه می‌شود معرفی تراشه RTX Spark از سوی انویدیا نشان داد که پردازنده مرکزی ۲۰ هسته‌ای این چیپست با یک پردازنده گرافیکی بلک‌ول جفت خواهد شد، اما جزئیات پیرامون پردازشگر گرافیکی بسیار محدود بود. خوشبختانه، بررسی دقیق‌تر آخرین درایورهای ویندوز ۱۱ ما را یک قدم به شناخت این SoC، به ویژه تعداد هسته‌های کودای (CUDA) آن نزدیک‌تر می‌کند. بر اساس آخرین یافته‌ها، RTX Spark در دو نسخه مختلف روانه بازار خواهد شد. نسخه ضعیف‌تر RTX Spark دارای ۵,۱۲۰ هسته کودا خواهد بود اولین درایور گرافیکی GeForce برای RTX Spark توسط انویدیا منتشر شده است. این درایور در نسخه 616.00 به عنوان پیش‌نمایشی برای توسعه‌دهندگان شناخته می‌شود و عمومی نیست. اگرچه این درایور برای استفاده روی لپ‌تاپ‌های مصرفی در نظر گرفته نشده، اما این موضوع جلوی کشف اطلاعات درباره محصول انویدیا را نگرفته است. وب‌سایت Windows Latest با بررسی این درایور متوجه فایلی به‌نام nv_surface_woa.inf شده که حاوی تمام اطلاعات لازم درباره دستگاهی است که درایور روی آن نصب می‌شود. این فایل شامل دو پیکربندی از RTX Spark با برچسب «NVIDIA RTX Spark N1X» است که یکی از مدل‌ها دارای پردازشگر گرافیکی بلک‌ول با ۶,۱۴۴ هسته و مدل دیگر دارای ۵,۱۲۰ هسته کودا است. احتمال زیادی وجود دارد که نسخه رده‌بالا با بیشترین تعداد هسته، با پردازنده ۲۰ هسته‌ای مدیاتک و ۴۸ واحد چندپردازنده جریانی (SM) جفت شود، درحالی‌که مدل کندتر با یک پردازنده ۱۸ هسته‌ای و ۴۰ واحد چندپردازنده جریانی تجهیز خواهد شد. خوشبختانه، انویدیا اعلام کرده است که حداکثر حافظه پشتیبانی‌شده ۱۲۸ گیگابایت رم LPDDR5X خواهد بود، بنابراین کاربرانی که بخواهند می‌توانند کمی از عملکرد پردازشی و گرافیکی چشم‌پوشی کنند اما ظرفیت کامل رم را داشته باشند. READ بدترین پسوردهای 2018؛ نام رئیس جمهور آمریکا و 123456 در بین محبوب‌هاتوجه به این نکته حائز اهمیت است که تعداد هسته‌های CUDA لزوماً نشان‌دهنده عملکرد نهایی RTX Spark نیست، زیرا نسخه دارای ۶,۱۴۴ هسته این مشخصات را با کارت گرافیک دسکتاپ RTX 5070 و لپ‌تاپ RTX 3080 به اشتراک می‌گذارد. به همین ترتیب، یک لپ‌تاپ مجهز به RTX 3070 دارای ۵,۱۲۰ هسته کودا است که مشابه نسخه ضعیف‌تر RTX Spark محسوب می‌شود؛ بااین‌حال، گزارش شده است که بازی‌های سنگینی مانند Alan Wake 2 و PRAGMATA روی این پلتفرم و حتی با فعال بودن قابلیت رهگیری پرتو به صورت روان اجرا می‌شوند.

مدیر 3 ماه قبل
1 دقیقه زمان مطالعه

گوگل روی تراشه هوش مصنوعی جدیدی با معماری مدل‌های جمینای کار می‌کند

این تراشه می‌تواند به ازای هر وات مصرف انرژی، بین ۶ تا ۱۰ برابر بیشتر از جدیدترین نسل واحدهای پردازش تنسور گوگل، توکن پردازش کنند. The post گوگل روی تراشه هوش مصنوعی جدیدی با معماری مدل‌های جمینای کار می‌کند appeared first on دیجیاتو.

مدیر 3 ماه قبل
1 دقیقه زمان مطالعه

انویدیا بی‌سروصدا درحال خرید فیبر نوری تاریک با پهنای باند ۷.۶ پتابیت‌برثانیه‌ای است

انویدیا بی‌سروصدا در حال خرید حجم عظیمی فیبر تاریک در سراسر آمریکاست؛ ظرفیتی که شاید به ۷.۶ پتابیت‌برثانیه برسد. The post انویدیا بی‌سروصدا درحال خرید فیبر نوری تاریک با پهنای باند ۷.۶ پتابیت‌برثانیه‌ای است appeared first on دیجیاتو.

مدیر 4 ماه قبل
1 دقیقه زمان مطالعه

سامسونگ شتاب‌دهنده هوش مصنوعی Gaia را برای کامپیوترها آماده می‌کند

سامسونگ شتاب‌دهنده هوش مصنوعی Gaia را برای کامپیوترها آماده می‌کند طبق گزارش‌ها، سامسونگ درحال ارسال نمونه‌های اولیه پردازنده هوش مصنوعی اختصاصی خود برای نسل بعدی کامپیوترهای AI به سازندگان پیشرو کامپیوتر، مانند اچ‌پی و لنوو است. به گزارش رسانه Chosun، این تراشه که با نام رمز Gaia توسعه یافته است، توسط واحد تجاری System LSI این شرکت طراحی شده و هدف آن کاهش بارهای کاری مرتبط با هوش مصنوعی از روی دوش پردازنده مرکزی (CPU) و پردازشگر گرافیکی (GPU) است. برنامه‌ریزی سامسونگ برای عرضه تراشه هوش مصنوعی Gaia تراشه Gaia سامسونگ برای سرعت بخشیدن به بارهای کاری هوش مصنوعی مولد در کامپیوترها طراحی شده و با استفاده از فرایند ساخت کلاس ۴ نانومتری این شرکت تولید می‌شود. این تراشه که اساساً یک واحد پردازش عصبی (NPU) است، درحال‌حاضر توسط شرکت HP در ایالات متحده و لنوو در چین درحال ارزیابی است تا عملکرد آن سنجیده شود و بررسی کنند آیا ادغام Gaia در سیستم‌هایشان که برای اواخر ۲۰۲۷ یا اوایل ۲۰۲۸ برنامه‌ریزی شده‌اند، منطقی است یا خیر. این گزارش جزئیاتی درباره اینکه Gaia چه تفاوت‌هایی با NPUهای یکپارچه موجود در پردازنده‌های رایزن ای‌ام‌دی، اینتل یا اسنپدراگون کوالکام دارد و آیا می‌تواند مزایای عملکردی چشمگیری ارائه دهد یا خیر، ارائه نمی‌دهد. بااین‌حال، گزارش‌ها حاکی از آن است که این NPU (یا احتمالاً مشتقات آن بر اساس همان معماری) می‌تواند برای پیاده‌سازی‌های نسل بعدی سامسونگ از فناوری پردازش درون حافظه (PIM) استفاده کند. فناوری اصلی PIM سامسونگ به‌گونه‌ای طراحی شده بود که منطق محاسباتی را مستقیماً درون آرایه حافظه HBM تعبیه کند و جابه‌جایی داده‌ها را بین ماژول‌های حافظه HBM و پردازنده‌های میزبان کاهش دهد. هدف PIM تسریع بارهای کاری خاص بود، اما برخلاف GPUهای هوش مصنوعی و HPC که بسیار کارآمد شده و از اکوسیستم‌های بالغی برخوردار بودند، PIM نتوانست چندان همه‌گیر شود. READ اپ هواشناسی سامسونگ در One UI 8 تغییرات بزرگی خواهد داشتشاید اگر NPU آتی Gaia بتواند حمایت سازندگان سخت‌افزار و شرکای اکوسیستم را جلب کند، این امر به تقویت پیاده‌سازی نسل بعدی PIM سامسونگ نیز کمک کند. بااین‌حال، NPUهای مستقل و PIM از اساس به قدری با یکدیگر متفاوت هستند که تصور اشتراک‌گذاری یک معماری مشترک دشوار است. با این وجود، منطق PIM می‌تواند از نظر دستورالعمل‌های پشتیبانی‌شده و فرمت‌های داده، زیرمجموعه‌ای از یک NPU باشد و این دو بخش مطمئناً می‌توانند یک چارچوب نرم‌افزاری مشترک را به اشتراک بگذارند. یکی از نکات جالب توجه درباره Gaia این است که ظاهراً توسط بخش LSI سامسونگ توسعه یافته است؛ یعنی همان واحد تجاری در این شرکت که مسئولیت توسعه پردازنده‌های اگزینوس (Exynos)، راهکارهای خودرویی، تراشه‌های ارتباطی، پردازنده‌های سیگنال تصویر (ISP)، پردازنده‌های سیگنال دیجیتال (DSP)، درایورهای نمایشگر و سنسورهای تصویر را برعهده دارد. با توجه به ماهیت چندبعدی واحد LSI سامسونگ و اهمیت استراتژیک آن برای این شرکت، سامسونگ قطعاً امید زیادی به موفقیت تراشه Gaia دارد.

مدیر 4 ماه قبل
1 دقیقه زمان مطالعه

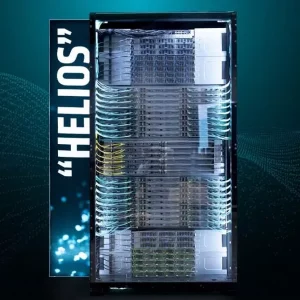
تهاجم به قلمرو انویدیا؛ AMD اولین سیستم رک هوش مصنوعی خود را با نام Helios معرفی کرد

تهاجم به قلمرو انویدیا؛ AMD اولین سیستم رک هوش مصنوعی خود را با نام Helios معرفی کرد شرکت AMD پس از یک دهه تلاش برای بازگشت به روزهای اوج، خود را برای عرضه نخستین سیستم در مقیاس رک برای هوش مصنوعی به نام هلیوس (Helios) آماده می‌کند. این سیستم برای فهرستی از مشتریان بزرگ که اکنون نام مایکروسافت نیز در میان آنها دیده می‌شود، ارسال خواهد شد. Helios اولین رقیب جدی برای سیستم‌های بسیار محبوب Grace Blackwell و ورا روبین انویدیا محسوب می‌شود و هدف آن ایجاد رقابتی واقعی در بازار تراشه‌ها پس از سال‌ها انحصار انویدیا است. سیستم جدید Helios وظیفه پردازش استنتاج مدل‌های پیشرو را برای مایکروسافت و مشتریان هوش مصنوعی آن برعهده خواهد داشت. همچنین، مایکروسافت دو نمونه پردازشی جدید مبتنی بر آخرین پردازنده‌های مرکزی AMD با نام Venice را برای هوش مصنوعی ایجنت‌محور، پایپ‌لاین‌های داده و طراحی نیمه‌هادی‌ها اضافه خواهد کرد. سیستم رک هوش مصنوعی AMD Helios نام هلیوس از خدای یونان باستان گرفته شده است و چهار فناوری داخلی AMD یعنی پردازشگرهای گرافیکی (GPU)، پردازنده‌های مرکزی (CPU)، شبکه و نرم‌افزار را ترکیب می‌کند. «فورست نورود»، مدیر بخش دیتاسنتر AMD، اعلام کرد که این شرکت بر ارائه بهترین هزینه مالکیت کلی و کمترین هزینه به ازای هر توکن تمرکز دارد. «لیزا سو»، مدیرعامل AMD، نیز به این موضوع اشاره کرده که هلیوس در زمینه‌های استنتاج، پهنای باند حافظه و قابلیت‌های آن، مزایای چشمگیری نسبت به سیستم‌های انویدیا دارد. هریک از ۱۸ سینی پردازشی Helios شامل چهار پردازشگر گرافیکی Instinct است که توسط پردازنده مرکزی EPYC پشتیبانی می‌شود. همچنین فناوری شبکه این سیستم از طریق شرکت Pensando که در سال ۲۰۲۲ توسط AMD خریداری شد، تأمین می‌شود. READ موبایل های Mate 9 و Mate S2 هوآوی مجهز به دوربین دوگانه لایکا خواهند بود مایکروسافت اعلام کرده که از سیستم هلیوس در مراکز داده خود استفاده خواهد کرد تا به شرکت‌هایی مانند متا، OpenAI و اوراکل در رقابت برای دستیابی به بالاترین توان پردازشی بپیوندد. AMD از اواخر سال جاری میلادی ارسال این سیستم‌ها را به مشتریان خود آغاز خواهد کرد. هرچند جزئیات مالی این قراردادها فاش نشده، اما «ساتیا نادلا»، مدیرعامل مایکروسافت، در بیانیه‌ای اعلام کرده که این شرکت درحال گسترش سبد زیرساختی Azure با هلیوس است تا عملکرد، مقیاس‌پذیری و حق انتخاب مورد نیاز مشتریان را برای ساخت و اجرای نسل بعدی برنامه‌های هوش مصنوعی فراهم کند. مؤسسه Futurum Group پیش‌بینی کرده که قیمت هر سیستم Helios احتمالاً بین ۵ تا ۵.۵ میلیون دلار خواهد بود که از سیستم نسل دوم Vera Rubin انویدیا با قیمت ۳.۵ تا ۴ میلیون دلار، گران‌تر است. Helios با وزن نزدیک به ۳۱۷۵ کیلوگرم، عریض‌تر و سنگین‌تر از سیستم ورا روبین است. در‌حال‌حاضر انویدیا بیش از ۹۵ درصد از بازار پردازشگرهای گرافیکی دیتاسنترها را در اختیار دارد و سهم AMD تنها حدود ۴.۵ درصد است، اما تحلیلگران معتقدند هلیوس می‌تواند سهم ای‌ام‌دی را به ۲۰ تا ۲۵ درصد برساند که معادل صدها میلیارد دلار درآمد خواهد بود.

مدیر 4 ماه قبل
1 دقیقه زمان مطالعه

TSMC به‌دلیل مصرف ۹ درصد از برق تایوان احتمالاً ملزم به تولید برق خود می‌شود

TSMC به‌دلیل مصرف ۹ درصد از برق تایوان احتمالاً ملزم به تولید برق خود می‌شود تایوان قصد دارد تمامی مصرف‌کنندگان بزرگ تجاری برق را ملزم به نصب زیرساخت‌های تولید و ذخیره‌سازی انرژی اختصاصی کند. این قانون جدید که مدارس و بیمارستان‌ها از آن مستثنی هستند، هزینه‌های سربار مربوط به انرژی را برای شرکت TSMC به شدت افزایش خواهد داد. TSMC مزایای اقتصادی استفاده از شبکه برق سراسری را از دست می‌دهد وزارت امور اقتصادی تایوان درحال هدایت اصلاحیه‌ای بر «قانون مدیریت انرژی» است که قرار است در تاریخ ۲۲ ژوئیه (۳۱ تیر) در مجلس این کشور مطرح شود. لازم به ذکر است که «مقررات توسعه انرژی‌های تجدیدپذیر» و قوانین فرعی مرتبط با آن در تایوان، هم‌اکنون مصرف‌کنندگان بزرگ تجاری را ملزم می‌کند تا ۱۰ درصد از مصرف برق خود را از طریق منابع تجدیدپذیر تأمین کنند. اما اصلاحیه جدید، تمامی مصرف‌کنندگان بزرگ را موظف می‌کند که زیرساخت‌های تولید و ذخیره‌سازی انرژی اختصاصی خود را نصب کنند. این وزارتخانه قصد دارد تمامی نهادهای تجاری با بار مصرف برق ۵ مگاوات یا بیشتر را در حیطه این اصلاحیه قرار دهد که شامل بیش از ۴۰۰ کارخانه نیمه‌هادی، اپتوالکترونیک، فولاد، پتروشیمی و همچنین مراکز داده هوش مصنوعی می‌شود. بدیهی است که به عنوان بزرگ‌ترین مصرف‌کننده برق در تایوان، شرکت TSMC در صورت تبدیل شدن این طرح به قانون، بیشترین تأثیر را خواهد پذیرفت. در نهایت، اگر شبکه عظیم کارخانه‌های این شرکت مجبور شود با نیروگاه‌های اختصاصی برق خود را تأمین کند، TSMC مزایای اقتصادی حاصل از خرید برق از شبکه سراسری را از دست خواهد داد. این اصلاحیه برای نصب زیرساخت‌های انرژی مورد نیاز، یک دوره تنفس در نظر می‌گیرد و سپس در صورت عدم رعایت آن، جریمه‌های مالی اعمال خواهد شد. برای آگاهی بیشتر، TSMC درحال‌حاضر تأسیسات ساخت تراشه زیر را در تایوان فعال نگه داشته است: ۶ کارخانه ۱۲ اینچی GIGAFAB شامل فب 12، 14، 15، 18، 20 و 22. ۴ کارخانه ۸ اینچی شامل فب 3، 5، 6 و 8. ۱ کارخانه ۶ اینچی به نام فب 2. همچنین تعدادی کارخانه بسته‌بندی پیشرفته. READ تیم کوک: اپل در ۶ سال گذشته هر ۳ تا ۴ هفته یک کمپانی را تصاحب کرده استنکته قابل تأمل این است که TSMC در سال ۲۰۲۴ حدود ۲۵.۵۵ میلیارد کیلووات‌ساعت برق در تایوان مصرف کرده که معادل حدود ۹ درصد از کل مصرف برق این کشور بوده است. جایگزین کردن این حجم از مصرف با برق حاصل از نیروگاه‌های اختصاصی، خود به تنهایی یک کار هرکول‌وار و بسیار دشوار خواهد بود.

مدیر 4 ماه قبل
1 دقیقه زمان مطالعه

انویدیا برای عرضه RTX Spark آماده می‌شود؛ انتشار اولین درایورها برای ویندوز آرم

انویدیا برای عرضه RTX Spark آماده می‌شود؛ انتشار اولین درایورها برای ویندوز آرم انویدیا در حال آماده‌سازی برای عرضه تراشه‌های فوق‌سریع «RTX Spark» در پاییز امسال است و به همین منظور، اولین نسخه پیش‌نمایش درایورهای بومی خود را برای «ویندوز روی آرم» منتشر کرده است. آغاز عرضه سیستم‌های RTX Spark به توسعه‌دهندگان ابرتراشه NVIDIA RTX Spark که برای کامپیوترهای هوش مصنوعی (AI PC) طراحی شده، طی چند ماه آینده در قالب لپ‌تاپ‌ها و مینی‌کامپیوترهای متنوع وارد بازار خواهد شد. این سیستم‌ها ترکیبی از قدرت معماری پردازنده «Grace» و پردازشگر گرافیکی «Blackwell» را به همراه ۱۲۸ گیگابایت حافظه در یک تراشه واحد ارائه می‌دهند که توسط اتصالات پرسرعت به هم متصل شده‌اند و اختصاصاً برای پردازش‌های هوش مصنوعی طراحی شده‌اند. انویدیا امروز اولین درایورهای پیش‌نمایش توسعه‌دهنده برای پلتفرم RTX Spark را با نسخه 616.00 منتشر کرد. این درایور مشخصاً برای کیت توسعه‌دهنده «Microsoft Surface RTX Dev Box» طراحی شده که راهکاری متمرکز بر توسعه‌دهندگان است و از طراحی بدون فن بهره می‌برد. پشتیبانی بومی از ویندوز Arm64 در CUDA 13.4 بسته نرم‌افزاری «CUDA 13.4 Toolkit» نیز پشتیبانی از RTX Spark را تحت عنوان «Windows on Arm» معرفی کرده است. طبق اعلام انویدیا، این پیش‌نمایش شامل فعال‌سازی کامپایلر و سیستم‌های ساخت برای اهداف Windows Arm64 است که قابلیت‌های زیر را فراهم می‌کند: توسعه بومی Windows Arm64 برای دستگاه‌های آینده RTX Spark. کامپایل متقاطع (Cross-compiling) اپلیکیشن‌های CUDA تحت Windows Arm64 با استفاده از کیت ابزار Windows x86_64. از نسخه CUDA 13.4 به بعد، درایور دیگر درون کیت ابزار قرار نخواهد داشت و به صورت جداگانه در قالب «NVIDIA Developer Driver» (نسخه R616 و بالاتر) عرضه می‌شود. انویدیا به توسعه‌دهندگان توصیه کرده است که پورت کردن اپلیکیشن‌های خود به ویندوز روی آرم را با شناسایی وابستگی‌های ناسازگار آغاز کنند تا برنامه‌هایشان برای عرضه انبوه کامپیوترهای RTX Spark در پاییز ۲۰۲۶ آماده باشد. انویدیا در مسیر توسعه برای RTX Spark راهنمای گام‌به‌گامی ارائه کرده و برخی مشکلات شناخته‌شده را نیز ذکر کرده است: کاهش عملکرد انتقال CUDA: انتقال داده از میزبان به دستگاه در حافظه‌های Pageable ممکن است عملکرد پایین‌تری از حد انتظار داشته باشد. (راهکار: استفاده از حافظه‌های Page-locked). سیاه شدن موقت صفحه: هنگام نصب درایور، صفحه نمایش ممکن است حدود دو دقیقه سیاه بماند که پس از آن به طور خودکار بازیابی می‌شود. ناپایداری در PyTorch: اجرای جریان‌های کاری CI/CD در PyTorch ممکن است منجر به اتمام زمان GPU و ناپایداری سیستم شود که در دست بررسی است. عدم دسترسی به Nsight Copilot: این قابلیت در نسخه پیش‌نمایش توسعه‌دهنده غیرفعال است. READ IBM و Nvidia پرسرعت ترین ابر رایانه ی جهان را می سازنددر نمایشگاه Computex 2026، سیستم‌های RTX Spark عملکرد خیره‌کننده‌ای در ابزارهای تولید محتوا، بازی‌ها و اپلیکیشن‌های هوش مصنوعی از خود نشان دادند. بااین‌حال، نتایج بنچمارک‌های منتشر شده بر اساس نمونه‌های مهندسی اولیه بوده و باید تا پاییز ۲۰۲۶ منتظر ماند تا عملکرد واقعی این تراشه‌ها در محصولات نهایی بررسی شود.

مدیر 4 ماه قبل
کالا هایی که دیده ایید !
شما این محصولات را انتخاب کرده اید0
empty-cart

هیچ محصولی در سبد خرید نیست.

جهت مشاهده محصولات بیشتر به صفحات زیر مراجعه نمایید.
کامپیوتر همه کاره 18.5 اینچ مدل PC185I52B

حسین نیکوکار

کامپیوتر همه کاره 18.5 اینچ مدل PC185I52B
2 روز پیش خریداری شدهتایید شده