برچسب: پردازنده

1 دقیقه زمان مطالعه

اینتل با جایگزینی فناوری Foveros با UCIe هزینه تولید Wildcat Lake را کاهش داد

اینتل با جایگزینی فناوری Foveros با UCIe هزینه تولید Wildcat Lake را کاهش دادپردازنده‌های Wildcat Lake اینتل با نام Core Series 3 با حذف برخی قابلیت‌های سری Ultra و استفاده از طراحی و بسته‌بندی ساده‌تر، به راهکاری کم‌هزینه‌تر برای کامپیوترهای شخصی تبدیل شده‌اند. اینتل چند ماه پیش پردازنده‌های Wildcat Lake Core Series 3 را عرضه کرد. این تراشه‌های اقتصادی برای بازار کامپیوترهای شخصی طراحی شده‌اند و از همان معماری Panther Lake استفاده می‌کنند، اما در قالب بسته‌بندی‌هایی با تمرکز بیشتر بر کاهش هزینه تولید عرضه می‌شوند. Wildcat Lake فقط یک پروژه برای کاهش هزینه در سطح تراشه نبود. اینتل پیش‌تر از پروژه‌ای با نام Project Firefly نیز صحبت کرده بود که هدف آن بهینه‌سازی محصولاتی مبتنی بر Wildcat Lake بود تا این محصولات بتوانند استانداردهای مورد انتظار سایر شرکت‌های فعال در این بخش، مانند MacBook Neo اپل، را رعایت کنند. ایده اصلی Wildcat Lake ساده بود: اینتل می‌خواست پردازنده‌ای مقرون‌به‌صرفه برای کامپیوترهایی مانند لپ‌تاپ‌ها ارائه دهد که در عین قیمت پایین، قابلیت‌هایی را که برای طیف گسترده‌ای از کاربران اهمیت بیشتری دارند حفظ کند. این تراشه همچنین از فناوری‌های ارتباطی جدید مانند تاندربولت 4، وای‌فای 7 و بلوتوث 6 پشتیبانی می‌کند و قرار است فراتر از لپ‌تاپ‌ها، در محصولات و کاربردهای لبه مانند ربات‌ها، ساختمان‌های هوشمند، ترمینال‌ها و پلتفرم‌های جلسات هوشمند نیز مورد استفاده قرار بگیرد. اینتل همچنین نمی‌خواست کاهش هزینه به افت شدید عملکرد منجر شود. در نتیجه، پردازنده‌های Wildcat Lake Core Series 3 می‌توانند تا ۲.۷ برابر عملکرد سریع‌تری در پردازش‌های هوش مصنوعی ارائه دهند و به ۴۰ تریلیون عملیات در ثانیه (TOPS) در سطح پلتفرم برسند. این پردازنده‌ها همچنین در طراحی‌های باریک و سبک، عمر باتری یک‌روزه و تا ۲.۱ برابر عملکرد بهتر در تولید محتوا و بهره‌وری ارائه می‌کنند، درحالی‌که مصرف توان پردازنده آن‌ها ۶۴ درصد کمتر از تراشه‌های Core 100 Series یا Raptor Lake U Refresh است. اولین قدم اینتل برای تبدیل Wildcat Lake به یک پلتفرم مقرون‌به‌صرفه، از بخش بسته‌بندی تراشه آغاز شد. اینتل برای این منظور، راهکار Foveros مورد استفاده در Panther Lake Core Ultra Series 3 را کنار گذاشت و به سراغ بسته‌بندی چندتراشه‌ای (Multi-Chip Package یا MCP) با بستر ارگانیک رفت. با این تغییر، دیگر نیازی به Base Die یا تراشه پایه وجود نداشت. در نتیجه، هزینه مونتاژ کاهش پیدا کرد و میزان تراشه‌های غیرقابل‌استفاده ناشی از افت بازده تولید نیز کمتر شد. بسته‌بندی MCP مزایای دیگری هم داشت که از تعداد کمتر سیگنال‌ها و روش‌های مدیریت توان ناشی می‌شد. اینتل در کنفرانس Hot Chips اعلام کرد که استفاده از بسته‌بندی یکپارچه یا Monolithic را نیز بررسی کرده بود، اما در نهایت MCP را انتخاب کرد؛ چراکه این روش برای تراشه‌ای که درحال ساخت آن بودند، بهترین تعادل میان هزینه و قابلیت‌ها را ارائه می‌کرد. از نظر فناوری ساخت نیز Intel 18A انتخاب منطقی برای بخش پردازشی بود، زیرا امکان استفاده از UCIe را برای طراحی‌های دو تراشه‌ای فراهم می‌کرد. در مقابل، فناوری TSMC N6 برای ساخت تراشه I/O انتخاب شد. نتیجه این تصمیم‌ها، تراشه‌ای بسیار ساده‌تر و کم‌هزینه‌تر بود. مهم‌ترین تفاوت‌های Wildcat Lake با Panther Lake شامل موارد زیر می‌شود: حداکثر ۲ هسته Xe برای iGPU در برابر ۴ هسته: قابلیت XMX برای پردازش‌های هوش مصنوعی حفظ شده، اما قابلیت Ray Tracing حذف شده است.حداکثر یک موتور NPU در برابر ۳ موتور: NPU به ۱۷ TOPS و کل پلتفرم به ۴۰ TOPS می‌رسد، درحالی‌که رقم قبلی ۵۳ TOPS بود.حداکثر ۲ هسته P-Core در برابر ۴ هسته: عملکرد تک‌هسته‌ای مشابه حفظ شده، اما حافظه کش LLC از ۱۲ مگابایت به ۶ مگابایت کاهش یافته است.حذف IPU: بخش ISP مبتنی بر USB2 برای دوربین حذف شده است.حذف قابلیت‌های حرفه‌ای بخش Media.کاهش رابط حافظه به LP5 با عرض ۶۴ بیت در برابر ۱۲۸ بیت: حافظه کش سیستمی نیز از ۴ مگابایت به ۲ مگابایت کاهش یافته است.حداکثر ۳ مسیر نمایشگر در برابر ۴ مسیر: پشتیبانی از نمایشگر 4K با نرخ ۶۰ هرتز و UHBR20 همچنان حفظ شده است.NPU این پردازنده به ۱۷ TOPS کاهش یافته است. بنابراین Wildcat Lake به حداقل مورد نیاز ۴۰ TOPS برای Copilot+ نمی‌رسد، اما از نظر قابلیت‌ها در سطح پردازنده‌های Core Ultra Series 1 اینتل قرار می‌گیرد. این NPU بیشتر برای کاربردهایی طراحی شده که تأثیر قابل‌توجهی روی عمر باتری دارند؛ از جمله افکت‌های ویدیویی هنگام برگزاری جلسات آنلاین، جست‌وجوی معنایی، قابلیت‌های امنیتی و ابزارهای مربوط به سلامت سیستم. برای کاربردهای پیشرفته‌تر هوش مصنوعی، اینتل استفاده از پلتفرم‌های Core Ultra را پیشنهاد می‌کند. این تغییرات باعث شدند اندازه بخش پردازشی تراشه که شامل GPU و CPU است، ۳۸ درصد کاهش پیدا کند. اما اینتل به همین بخش بسنده نکرد و اندازه تراشه I/O نیز با بهینه‌سازی مجموعه قابلیت‌های آن ۱۵ درصد کاهش یافت. در بخش I/O، قابلیت‌های ضروری برای کاربران عادی حفظ شده‌اند، از جمله: ۲ پورت Thunderbolt/USB4 در برابر ۳ پورت با eDP Muxing و ۴ پورت فیزیکی۶ مسیر PCIe Gen4 در برابر ۴ مسیر Gen5 و ۸ مسیر Gen4همان تعداد پورت USB: شامل ۲ پورت USB 3.2 و ۸ پورت USB 2.0حذف Camera PHY در مقایسه با CSI۲ اسپیکر و ۲ میکروفون با ۳ DSP و ۳ مگابایت حافظه در برابر ۴ اسپیکر و میکروفون با ۵ DSP و ۴.۶ مگابایت حافظهتغییرات جزئی در بخش‌های عمومی تراشه که در نهایت باعث کاهش مشکلات می‌شوند.استفاده از بسته‌بندی Organic MCP باعث شد ابعاد کلی تراشه نیز کاهش پیدا کند؛ زیرا تعداد I/Oهای مورد نیاز کمتر شده است. بسته‌بندی کوچک‌تر فضای کمتری روی برد اشغال می‌کند و تغییرات اعمال‌شده در سیستم تأمین توان نیز به کاهش بیشتر فضای مورد نیاز کمک کرده‌اند. ابعاد پردازنده Core Series 3 با بسته‌بندی MCP برابر ۳۵×۲۵×۱.۲۳ میلی‌متر است، درحالی‌که یک مدل Panther Lake مجهز به چهار هسته Xe ابعادی برابر با ۵۰×۲۵×۱.۵ میلی‌متر دارد. در بخش پلتفرم نیز یکی از مهم‌ترین عوامل کاهش هزینه به استفاده از حافظه DRAM با رابط ۶۴ بیتی مربوط می‌شود. این تغییر امکان استفاده از یک PCB شش‌لایه Type 3 را فراهم می‌کند، درحالی‌که طراحی قبلی به برد هشت‌لایه نیاز داشت. سیستم تأمین توان نیز برای بهبود عمر باتری به یک ریل LPAtom مجهز شده و از ICCMax و Load Lineهای بهینه‌تری بهره می‌برد. همچنین وای‌فای 7 به‌صورت یکپارچه در پلتفرم قرار گرفته است؛ بنابراین دیگر نیازی به نصب ماژول خارجی روی برد وجود ندارد. اما مهم‌ترین تغییر بدون شک استفاده از MCP مبتنی بر UCIe است. اینتل توضیح داده که هنگام تعریف Wildcat Lake در حدود سال ۲۰۲۲، استاندارد UCIe هنوز منتشر نشده بود. اما پس از انتشار نخستین مشخصات این استاندارد، اینتل تصمیم گرفت به‌جای Foveros از UCIe در یک طراحی MCP دو تراشه‌ای استفاده کند. این تغییر باعث صرفه‌جویی قابل‌توجهی در فضای تراشه شد و در نهایت هزینه تولید را در مقایسه با تراشه‌های Panther Lake کاهش داد. البته این روش یک نقطه ضعف نیز داشت. از آنجا که در این طراحی از Base Die استفاده نمی‌شود، فاصله بین نقاط اتصال یا Bump Pitch از ۳۶ میکرون در Foveros به ۱۱۰ میکرون در UCIe افزایش پیدا می‌کند. این فاصله بیشتر به نرخ انتقال بالاتر و فضای بزرگ‌تری برای بخش I/O و کنترلر نیاز دارد. به همین دلیل، رابط ارتباطی بین تراشه‌ها در Wildcat Lake که بر پایه UCIe ساخته شده، در نهایت ۷۰ درصد فضای بیشتری نسبت به Foveros در Wildcat Lake اشغال می‌کند. بااین‌حال، اینتل اعلام کرده است که افزایش فضای مورد نیاز UCIe در برابر صرفه‌جویی کلی حاصل از استفاده از بسته‌بندی MCP ارزش دارد. Wildcat Lake همچنین از بازده تولید بهتری در تراشه‌های جدید 18A برخوردار است؛ موضوعی که برای کاهش هزینه اهمیت زیادی دارد، به‌خصوص در یک فناوری ساخت جدید مانند 18A. اینتل نیز مدل‌های مختلفی از پردازنده‌های Core Series 3 را ارائه می‌کند که هرکدام بر اساس فرکانس متفاوت CPU ،GPU و NPU دسته‌بندی می‌شوند. Wildcat Lake ممکن است در نگاه اول یک نسخه اقتصادی از Panther Lake به نظر برسد، اما در داخل خود تغییرات بسیار بیشتری دارد. اینتل حالا جزئیات تغییراتی را توضیح داده که Wildcat Lake را به یک طراحی بسیار بهینه‌تر برای بازار گسترده تبدیل کرده‌اند.

مدیر 2 ماه قبل
1 دقیقه زمان مطالعه

اینتل پردازنده‌های نسل بعدی Nova Lake را ابتدا برای دسکتاپ عرضه می‌کند

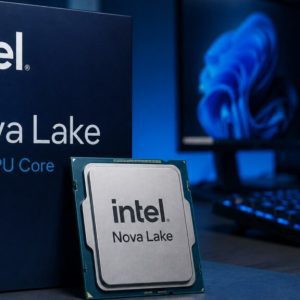
اینتل پردازنده‌های نسل بعدی Nova Lake را ابتدا برای دسکتاپ عرضه می‌کند همان‌طور که در جدیدترین مصاحبه یکی از مدیران اینتل تأیید شده است، تیم تراشه‌ساز آبی رویکرد متفاوتی را برای معماری پردازنده نسل بعدی خود در پیش گرفته است. اینتل با نوا لیک AMD را هدف قرار می‌دهد اینتل تأیید کرده است که هسته پردازشی نسل بعدی آن که به معماری نوا لیک (Nova Lake) مربوط می‌شود، پیش از راهی شدن به سمت مراکز داده، روی پلتفرم‌های دسکتاپ عرضه خواهد شد. این موضوع توسط «رابرت هالوک»، نایب‌رئیس و مدیرکل این شرکت، در گفتگو با رسانه Tom's Hardware و هنگام بحث درباره تصمیم AMD برای معرفی اولیه معماری Zen 6 در بازار سرور تأیید شد. هالوک در گفتگو با تامز هاردور گفت اینتل یک «هسته جدید» دارد که ابتدا به بازار دسکتاپ می‌آید و از علاقه‌مندان به دنیای سخت‌افزار خواست هنگام مقایسه استراتژی این شرکت با AMD، محاسبات لازم را انجام دهند. اگرچه هالوک در اظهارات خود صراحتاً نامی از نوا لیک نبرد، اما کاملاً مشخص است هسته جدیدی که او به آن اشاره می‌کرد به خانواده نوا لیک مربوط می‌شود. هالوک گفت: «آنچه می‌توانم بگویم این است که وقتی به نقشه راه خودمان فکر می‌کنم، یک هسته جدید داریم که ابتدا به دسکتاپ می‌آید. منظورم این است که امیدوارم علاقه‌مندان دراین‌باره قضاوت و محاسبات لازم را انجام دهند و این تمام چیزی است که می‌گویم.» این رویکرد بسیار جالب است؛ زیرا AMD اخیراً معماری Zen 6 خود را در بخش مرکز داده با پردازنده‌های EPYC ونیز معرفی کرده است. در همین حال، انتظار می‌رود محصولات سری مصرف‌کننده مبتنی بر Zen 6 سال آینده میلادی وارد بازار شوند. از سوی دیگر، اینتل پلتفرم دسکتاپ خود را برای کاربران خانگی در اولویت قرار داده و در بازار سرور با صبر و حوصله بیشتری عمل می‌کند. انتظار می‌رود نوا لیک دارای هسته‌های قدرتمند (P-Cores) با معماری Coyote Cove و هسته‌های کم‌مصرف (E-Cores) با معماری Arctic Wolf باشد که ابتدا برای دسکتاپ در دسترس قرار خواهند گرفت. اگرچه جزئیات دقیق هسته‌های پردازنده‌های Xeon 7 Diamond Rapids اینتل هنوز مشخص نیست، اما این احتمال وجود دارد که پردازنده‌های سرور نسل بعدی اینتل نیز از همین هسته‌ها استفاده کنند. انتظار می‌رود خانواده نوا لیک در اوایل سال ۲۰۲۷ عرضه شوند؛ یعنی همان بازه زمانی که انتظار می‌رود اینتل سری Raptor Lake NEXT را نیز برای پلتفرم DDR4 روانه بازار کند.

مدیر 3 ماه قبل
1 دقیقه زمان مطالعه

پردازنده‌های Xeon 7 اینتل برای رقابت با EPYC Venice به حداکثر ۲۵۶ هسته P مجهز می‌شوند

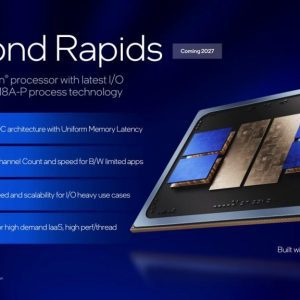
پردازنده‌های Xeon 7 اینتل برای رقابت با EPYC Venice به حداکثر ۲۵۶ هسته P مجهز می‌شوند پردازنده‌های دایموند رپیدز «Xeon 7» اینتل حداکثر ۲۵۶ هسته مبتنی بر فناوری نسل بعدی هسته‌های P را برای رقابت با پردازنده‌های EPYC ونیز شرکت AMD ارائه خواهند داد. اینتل و AMD در بخش پردازنده‌های مرکز داده با بیش از ۲۰۰ هسته به رقابت می‌پردازند؛ در حالی که دایموند رپیدز «Xeon 7» برای عرضه در سال ۲۰۲۷ برنامه‌ریزی شده است. برنامه‌های اولیه برای دایموند رپیدز، پلتفرم آینده زئون اینتل، بسیار جاه‌طلبانه بود. اما به نظر می‌رسد تراشه‌های عرضه‌شده نسخه سبک‌تری از آنچه در ابتدا برنامه‌ریزی شده بود خواهند بود. اگر گزارش‌های قبلی ما را درباره دایموند رپیدز به خاطر داشته باشید، درباره مدل‌های ۳۸۴ و ۵۱۲ هسته‌ای بحث کردیم که فراتر از هر چیزی در بازار هستند. این تعداد هسته برای پلتفرم‌های مرکز داده RRF و TDF بود. این تراشه‌ها قرار بود بخشی از طرح‌های Diamond Rapids-HD (چگالی بالا) باشند که جایگزین کلیرواتر فارست می‌شدند، بنابراین بر اساس هسته‌های E بودند، اما به نظر می‌رسد این برنامه‌ها لغو شده‌اند. جیکین (Jaykihn) می‌گوید که پلتفرم ۵۱۲ هسته‌ای در مرحله تعریف لغو شد و کل پلتفرم در ماه دسامبر سال گذشته به کلی دگرگون شد. اکنون تنها مدل‌های مجهز به هسته P باقی مانده‌اند. گفته می‌شود مدل‌های مجهز به هسته P دایموند رپیدز افزایشی ۵۰ درصدی در چگالی هسته ارائه می‌دهند. این امر حداکثر ۱۹۲ هسته را به ما می‌دهد، از آنجا که گرانیت رپیدز «Xeon 6900P» در حال حاضر حداکثر دارای ۱۲۸ هسته است. اما به نظر می‌رسد پرچمدار این سری دارای تعداد هسته حتی بیشتری خواهد بود. گزارش شده است که رده‌بالاترین مدل دایموند رپیدز «Xeon 7» اینتل دارای ۲۵۶ هسته P خواهد بود. این مدل ۲۵۶ هسته‌ای هنوز به طور رسمی معرفی نشده است زیرا این سبد محصولات هنوز به طور رسمی عرضه نشده است (اما در دست ساخت است، همان‌طور که اخیراً اولین نشت مشخصات مدل آن را دیدیم)، بنابراین باید دید که آیا اینتل این مدل را عرضه خواهد کرد یا خیر. مدل رده‌بالای دایموند رپیدز دارای ۲۵۶ هسته P است. — Jaykihn (@jaykihn0) August 8, 2026 اما یک مدل با ۲۵۶ هسته P قادر خواهد بود با حداکثر تعداد هسته پردازنده EPYC ونیز شرکت AMD رقابت کند که سقف آن ۲۵۶ هسته «Zen 6» است. شرکت AMD یک مدل ۲۵۶ هسته‌ای (EPYC 9996) و یک مدل ۱۹۲ هسته‌ای (EPYC 9966) در خانواده نسل ششم EPYC خود دارد. بنابراین اگر اینتل موفق شود یک مدل Xeon 7 با ۲۵۶ هسته عرضه کند، قادر خواهد بود از نظر تعداد هسته با هر دو رقابت کند. یک مدل ۲۵۶ هسته‌ای وجود دارد. — Jaykihn (@jaykihn0) August 9, 2026 سوال بزرگ‌تر این است که آیا تراشه‌های اینتل از منظر عملکرد و بهره‌وری به اندازه کافی رقابتی خواهند بود یا خیر. معماری Zen 6 جهش بزرگ دیگری را برای پردازنده‌های EPYC به ارمغان آورده است و تراشه‌های Xeon 7 اینتل در حال حاضر اصلاً در دسترس نیستند. این واقعیت که AMD تراشه خود را روی نود ۲ نانومتر و در تولید انبوه دارد در حالی که Xeon 7 برای سال ۲۰۲۷ روی نود 18A-P برنامه‌ریزی شده است، به این معناست که تیم آبی کارهای زیادی برای اثبات خود دارد. READ رونمایی ASRock از پنج مادربورد جدید از سری B365برای بدتر شدن اوضاع، انویدیا و چندین شرکت دیگر روی پردازنده‌های خود کار می‌کنند که به طور جدی وارد بخش هوش مصنوعی سازمانی و مراکز داده ابری می‌شوند. اما با توجه به نیاز به توان پردازشی بیشتر، شرکت‌های فناوری مشتاقانه هر میزان عرضه را که بتوانند به آن دسترسی داشته باشند، می‌بلعند. قیمت پردازنده‌های قدیمی‌تر اینتل پس از افزایش تقاضا بالا رفته است و این شرکت در حال حاضر تقاضای فزاینده‌ای را برای خدمات تولید تراشه خود تجربه می‌کند. بنابراین این مسائل وجود دارد، اما اینتل همچنان باید توانایی خود را به عنوان یک ارائه‌دهنده تراشه رده‌بالا به نمایش بگذارد و به‌نظر می‌رسد دایموند رپیدز گامی در آن جهت خواهد بود و کورال رپیدز ردپای رقابتی این شرکت را در این بخش‌های پردازنده و هوش مصنوعی بیشتر تقویت خواهد کرد.

مدیر 3 ماه قبل
1 دقیقه زمان مطالعه

یک یوتوبر دمای پردازنده رایزن 7 9800X3D را با خنک‌کننده دودکشی ۱۹ درجه پایین آورد

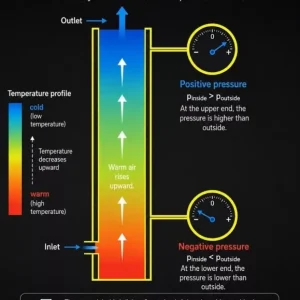
یک یوتوبر دمای پردازنده رایزن 7 9800X3D را با خنک‌کننده دودکشی ۱۹ درجه پایین آورد طراحی 3D V-Cache در پردازنده رایزن 7 9800X3D عملکرد بی‌نظیری در بازی‌ها ارائه می‌دهد، اما به‌عنوان یک پتوی حرارتی عمل می‌کند که توضیح می‌دهد چرا این پردازنده با وجود نصب خنک‌کننده مناسب، داغ‌تر از بیشتر مدل‌ها کار می‌کند. بااین‌حال، یک یوتوبر با توسعه یک دودکش که با پرینتر سه‌بعدی آن را چاپ کرده و ارتفاعش چند سانتی‌متر است، یک قدم فراتر رفته تا دما را به میزان چشمگیر ۱۹ درجه سانتی‌گراد کاهش دهد. تنها نکته منفی این است که قرار دادن این خنک‌کننده در کیس کامپیوتر کاربرهای عادی غیرممکن است. اثر «دودکش» به کاهش دما منجر می‌شود قطعات چاپ سه‌بعدی روی واترکولر پردازنده Ryzen 7 9800X3D نصب شدند تا مایع خنک‌کننده را به گردش درآورند؛ در همین حال، از یک رادیاتور ۲۴۰ میلی‌متریِ بدون فن برای دفع هوای گرم استفاده شد. در این پروژه، یوتوبر معروف حوزه سخت‌افزار موسوم به der8auer به جای استفاده از فن، محفظه‌هایی را طراحی کرد تا آن‌ها را روی یکدیگر قرار دهد. اتصال یک دودکش تک‌بخشیِ چاپ سه‌بعدی با ارتفاع ۲۰ سانتی‌متر نیز نتایج مثبتی به همراه داشت و توانست در شرایطی که پردازنده Ryzen 7 9800X3D حدود ۱۰۰ وات توان مصرف می‌کرد، دمای آن را تا حدودی کاهش دهد. با رسیدن ارتفاع این دودکش به ۱۱۰ سانتی‌متر (که تقریباً تا نزدیک سقف اتاق این یوتوبر می‌رسید)، دما به قدری افت کرد که der8auer به سختی می‌توانست اعداد ثبت‌شده را باور کند. این یوتوبر برای اثبات عملکرد سیستم خنک‌کننده ابداعی خود، از یک دستگاه مه‌ساز استفاده کرد تا به وضوح نشان دهد هوا چگونه به داخل محفظه کشیده می‌شود و «اثر دودکش» ایجاد می‌کند. READ گوگل یک مدل «زبان هوش مصنوعی» با یک تریلیون پارامتر را ایجاد کرددر حداکثر ارتفاع ممکن، دمای پردازنده Ryzen 7 9800X3D حدود ۱۹ درجه سانتی‌گراد افت کرد (از ۹۰ درجه به ۷۱ درجه سانتی‌گراد). این موضوع der8auer را به شدت تحت‌تأثیر قرار داد، چرا که در ویدیو اعتراف می‌کند اصلاً انتظار چنین نتایج فوق‌العاده‌ای را نداشته است. تنها نقطه ضعف برای کاربران عادی که می‌خواهند این روش را امتحان کنند، نیاز به فضای عمودی بسیار زیاد است. علاوه‌براین، علاقه‌مندان مجبورند تمام قطعات سیستم را روی یک تست‌بنچ (Test Bench) اسمبل کنند؛ زیرا عملاً هیچ راهی برای جای دادن این محفظه‌های مرتفع درون یک کیس استاندارد وجود ندارد.

مدیر 3 ماه قبل
1 دقیقه زمان مطالعه

معماری Zen 7 به‌عنوان آخرین نسل پردازنده‌های رایزن روی پلتفرم AM5 عرضه می‌شود

معماری Zen 7 به‌عنوان آخرین نسل پردازنده‌های رایزن روی پلتفرم AM5 عرضه می‌شود معماری Zen 7 شرکت AMD ممکن است به عنوان قدرت‌بخش آخرین خانواده رایزن روی پلتفرم AM5 عمل کند، درحالی‌که Zen 8 احتمالاً نخستین معماری روی پلتفرم‌های AM6 خواهد بود. پلتفرم AM5 که برای اولین‌بار در سال ۲۰۲۲ معرفی شد، تاکنون سه نسل از رایزن را به خود دیده است. سری رایزن ۷۰۰۰ با نام رمز «Raphael» اولین مورد بود، پس از آن رایزن 8000G با نام رمز «Hawk Point» آمد و جدیدترین آن‌ها سری رایزن ۹۰۰۰ با نام رمز «Granite Ridge» است. در مرحله بعد، AMD خانواده «Olympic Ridge» مبتنی بر Zen 6 خود را معرفی خواهد کرد که قرار است ارتقاهای خوبی را در تعداد هسته‌ها، سرعت کلاک، حافظه کش و سایر بهبودهای معماری روی یک فناوری پردازشی بهبودیافته به ارمغان بیاورد. ای‌ام‌دی در جریان رویداد Advancing AI 2026، دو معماری نسل بعدی Zen یعنی Zen 7 و Zen 8 را تشریح کرد و ما خواستیم نحوه تطابق آن‌ها را با نقشه راه دسکتاپ بررسی کنیم. تعهد AMD به پلتفرم AM5 و پیش‌نمایش نقشه راه Zen برای آخرین خانواده دسکتاپ رایزن AMD اول از همه، به نقشه راه آینده پلتفرم AM5 تا حوالی سال ۲۰۲۹ متعهد شده است. هنگامی که این پلتفرم برای اولین‌بار معرفی شد، AMD به برنامه پشتیبانی تا حوالی سال ۲۰۲۵ متعهد شد، سپس آن را به حوالی سال 2027 گسترش داد و سپس در سال جاری، آن را به حوالی 2029 رساند. پس حداقل یک معماری Zen دیگر یا یک خانواده رایزن دیگر را برای این پلتفرم فراهم می‌کند. واضح‌ترین خانواده رایزنی که پس از Zen 6 برای AM5 منطقی به نظر می‌رسد، Zen 7 است. Zen 7 برای عرضه در سال ۲۰۲۸ هدف‌گذاری شده است، اما مانند Zen 6 ،Zen 7 نیز احتمالاً ابتدا روی سرورها عرضه می‌شود و به دنبال آن انتشار نسخه دسکتاپ انجام می‌گیرد. پردازنده‌های EPYC مبتنی بر Zen 6 امسال عرضه می‌شوند، درحالی‌که رایزن Zen 6 اوایل سال آینده میلادی به بازار می‌آیند. بنابراین اگر AMD از یک روند زمانی ۲ ساله مشابه برای دسکتاپ‌ها پیروی کند، می‌توانیم انتظار عرضه پردازنده‌های رایزن مبتنی بر Zen 7 را در حدود سال ۲۰۲۹ داشته باشیم. برای Zen 7، شرکت AMD قصد دارد یک فناوری پردازشی نسل بعدی (احتمالاً A16 یا A14 شرکت TSMC یا ترکیبی از هر دو) و پشتیبانی از ACE (افزونه‌های محاسباتی هوش مصنوعی) را اتخاذ کند و همچنین آماده پشتیبانی از حافظه نسل بعدی LPDDR و MRDIMM خواهد بود. READ مک استودیو با تراشه M3 اولترا احتمالاً اواسط سال 2024 رونمایی می‌شودمعماری Zen 7 قابلیت‌های EPYC و Ryzen را روی پلتفرم‌های موجود گسترش می‌دهد خانواده نسل هفتم EPYC با نام رمز «Florence» همچنان پیرامون پلتفرم‌های SP7 و SP8 ساخته شده است که از استانداردهای DDR5 پشتیبانی می‌کنند، بنابراین انتقال به حافظه نسل بعدی DDR6 بعید به نظر می‌رسد. AMD احتمالاً به فناوری‌های سریع‌تر MRDIMM (با سرعت 17,600 MT/s) و LPDDR5X (با سرعت 12 GT/s به بالا) به عنوان نسل بعدی اشاره می‌کند. اگر AMD بخواهد به کنترلر حافظه DDR5 پایبند بماند، حضور Zen 7 روی AM5 تأیید می‌شود و بعید است که آن‌ها از همزمان از کنترلرهای حافظه داخلی DDR5 و DDR6 استفاده کنند، زیرا AMD قبلاً اعلام کرده است که تنها زمانی به سوکت‌های جدیدتر منتقل خواهد شد که جهش قابل توجهی در فناوری‌های حافظه یا I/O مانند DDR6 یا PCIe 6 وجود داشته باشد. استاندارد PCI Gen6 قبلاً با پردازنده‌های نسل ششم EPYC روی پلتفرم‌های SP7 و SP8 از راه رسیده است و شاید AMD اولین شرکتی باشد که قابلیت‌های PCIe 6 را پیش از پشتیبانی بومی در پلتفرم‌های آینده، روی پلتفرم‌های AM5 ارائه دهد. اما مصرف‌کنندگان هیچ مزیت عمده‌ای مشاهده نمی‌کنند زیرا SSDهای کلاینت نسل 6 هنوز چند سال با ما فاصله دارند و مزایای عملکردی به اندازه جهش از نسل 4 به نسل 5 ناچیز خواهد بود. همچنین، اگرچه پردازنده‌های گرافیکی نسل بعدی ممکن است از استانداردهای نسل 6 پشتیبانی کنند، باز هم PCIe 5.0 پهنای باند فراوانی ارائه می‌دهد. با تمام این تفاسیر، پلتفرم AM5 برای مصرف‌کنندگان، از سطح مبتدی گرفته تا حرفه‌ای‌ها، یک پلتفرم فوق‌العاده بوده است. اینکه Zen 7 آخرین خانواده Zen باشد، پایان فوق‌العاده‌ای برای یک پلتفرم خواهد بود، زیرا AMD با پلتفرم AM6 وارد عصر بعدی محاسبات دسکتاپ می‌شود. معماری Zen 8 پس از سال 2030 به پلتفرم‌های جدیدتر منتقل می‌شود بنابراین تعهد به برنامه پشتیبانی تا حوالی سال 2029 کاملاً منطقی است و Zen 7 به عنوان آخرین معماری برای تأمین قدرت پردازنده‌های دسکتاپ رایزن روی پلتفرم AM5 عمل خواهد کرد. با Zen 8، شرکت AMD قطعاً به سمت پلتفرم AM6 با پشتیبانی بومی از DDR6 و PCIe 6.0 حرکت خواهد کرد. خانواده نسل هشتم EPYC با نام رمز «Ravenna» نیز احتمالاً به سوکت‌ها و پلتفرم‌های سرور جدیدتر تغییر وضعیت خواهد داد، درحالی‌که در بخش دسکتاپ، AMD یک سوکت کاملاً جدید معرفی خواهد کرد تا سفر دسکتاپ بعدی خود را با جدیدترین و بهترین معماری‌های پردازنده Zen ادامه دهد. READ AMD پردازنده‌های گیمینگ جدید رایزن 9 X3D را 22 اسفند عرضه می‌کنداین رویکرد پشتیبانی چندساله نشان‌دهنده یک استراتژی هوشمندانه‌تر و کاربرپسندتر است که به کل اکوسیستم سود می‌رساند و ثابت می‌کند که یک پلتفرم مستحکم و با دوام طولانی غالباً بهتر از ارتقاهای مکرر سوکت یا پلتفرم است.

مدیر 3 ماه قبل
1 دقیقه زمان مطالعه

پردازنده‌ Medusa Point ای‌ام‌دی در بنچمارک جدید ۳۵ درصد برتر از نسل قبل ظاهر شد

پردازنده‌ Medusa Point ای‌ام‌دی در بنچمارک جدید ۳۵ درصد برتر از نسل قبل ظاهر شد پردازنده‌های Medusa Point شرکت AMD با معماری Zen 6 درحال پیشرفت هستند و براساس جدیدترین بنچمارک‌های فاش‌شده، عملکردی بسیار سریع‌تر از حد انتظار را به نمایش گذاشته‌اند. این تراشه‌ها که به نظر می‌رسید پیش از این دست‌کم گرفته شده بودند، اکنون با ثبت رکوردهای جدید در آزمون‌های مختلف نشان می‌دهند که AMD به دنبال جهش عملکردی بسیار بالاتری در مقایسه با نسل‌های گذشته است. براساس جدیدترین اطلاعات فاش‌شده در پلتفرم Geekbench، یک نمونه مهندسی از پردازنده‌های Medusa Point با شناسه 100-000001713-33_N روی پلتفرم AMD Plum-MDS1 رویت شده است. این تراشه ۱۰ هسته‌ای و ۲۰ رشته‌ای پیش از این در آزمون تک‌هسته‌ای امتیاز ۳۱۷۴ را کسب کرده بود، اما اکنون در جدیدترین بنچمارک خود موفق به ثبت امتیاز ۳۳۲۹ شده است که بهبود عملکرد ۵ درصدی را نشان می‌دهد. عملکرد پردازنده‌های Medusa Point با ثبت این امتیازات جدید، پردازنده ۱۰ هسته‌ای AMD نسبت به پردازنده‌های ۱۰ هسته‌ای سری Strix Point مانند Ryzen AI 9 365 نزدیک به ۳۵ درصد سریع‌تر عمل می‌کند؛ درحالی‌که در بنچمارک‌های قبلی این اختلاف حدود ۲۹ درصد بود. هرچند گیک‌بنچ همیشه به عنوان معتبرترین پلتفرم برای مقایسه سخت‌افزاری شناخته نمی‌شود، اما دیدگاهی کلی و تقریبی از جایگاه سخت‌افزار جدید در رده‌بندی عملکرد تک‌هسته‌ای و چندهسته‌ای ارائه می‌کند. در بخش عملکرد چندهسته‌ای نیز این نمونه مهندسی با کسب امتیاز ۱۶۵۵۵، بهبود عملکردی نزدیک به ۹ درصد را نسبت به رکورد قبلی خود ثبت کرده است. علاوه‌براین، برای نخستین بار جزئیاتی از فرکانس کاری این پردازنده‌ها فاش شده است که نشان می‌دهد فرکانس این تراشه در مراحل اولیه توسعه، ۳۰۰ مگاهرتز بالاتر از سریع‌ترین پردازنده‌های Strix Point است. بالاترین فرکانس ثبت‌شده در این آزمون ۵.۳۷ گیگاهرتز بوده که رقمی بسیار تحسین‌برانگیز است. با توجه به اینکه چندین ماه تا رونمایی رسمی از این محصولات باقی مانده، انتظار می‌رود در آینده نتایج بیشتری از آنها در پلتفرم‌های معتبرتری مانند Cinebench یا PassMark منتشر شود. READ مدل‌های آیفون 15 پرو ممکن است با قیمت بیشتری روانه بازار شوند

مدیر 4 ماه قبل
1 دقیقه زمان مطالعه

مرگ تدریجی قانون مور: وقتی فیزیک کوانتوم به کابوس مهندسان سیلیکون‌ولی تبدیل شد

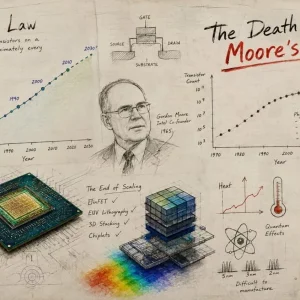
مرگ تدریجی قانون مور: وقتی فیزیک کوانتوم به کابوس مهندسان سیلیکون‌ولی تبدیل شد مقدمه: ضربان قلبی که جهان مدرن را کوک کرد در تاریخ نوزدهم آوریل سال 1965 میلادی، مجله «الکترونیکس» (Electronics) مقاله‌ای نسبتاً کوتاه از یک مهندس سی و شش ساله به نام گوردون مور (Gordon Moore) منتشر کرد. مور که سه سال بعد شرکت افسانه‌ای اینتل (Intel) را پایه‌گذاری کرد، در این مقاله پیش‌بینی جسورانه‌ای انجام داد: تعداد ترانزیستورهای روی یک مدار مجتمع (Microchip) هر سال (که بعدها به هر 18 تا 24 ماه اصلاح شد) تقریباً 2 برابر خواهد شد، در حالی که هزینه تولید آن‌ها کاهش می‌یابد. این پیش‌بینی ساده، به چیزی بیش از یک نظریه مهندسی تبدیل شد؛ این جمله به «قانون مور» معروف گشت و به عنوان ضربان قلب تپنده سیلیکون‌ولی، مسیر تکامل بشریت را در نیم قرن آینده دیکته کرد. به لطف این قانون بود که ما از کامپیوترهای غول‌پیکری که فضایی به اندازه یک اتاق کامل را اشغال می‌کردند، به گوشی‌های هوشمندی رسیدیم که در جیب جا می‌شوند و قدرت پردازشی میلیاردها برابر بیشتر از کامپیوترهای آپولو 11 دارند. اما هیچ مهمانی‌ای تا ابد ادامه نمی‌یابد. امروز، در اواسط دهه 2020 میلادی، صنعت نیمه‌رسانا با واقعیتی تلخ و گریزناپذیر روبرو شده است. مهندسانی که دهه‌ها با کوچک کردن ترانزیستورها معجزه می‌کردند، اکنون به دیواری سخت به نام «قوانین فیزیک بنیادین» برخورد کرده‌اند. داستان مرگ تدریجی قانون مور، قصه نبرد حماسی ذهن انسان با محدودیت‌های اتمی و کوانتومی است؛ نبردی که در آن، هر نانومتر با خون، عرق و میلیاردها دلار سرمایه فتح می‌شود. فصل اول: عصر طلایی کوچک‌سازی و ترانزیستورهای جادویی برای درک عمق بحران کنونی، باید ابتدا آناتومی یک پردازنده را به زبان ساده بشکافیم. پردازنده کامپیوتر یا گوشی شما، اساساً شهری مینیاتوری متشکل از میلیاردها کلید قطع و وصل جریان برق است. به این کلیدها «ترانزیستور» می‌گویند. وظیفه ترانزیستور بسیار ساده است: روشن بودن (نماد 1) و خاموش بودن (نماد 0). تمام دنیای دیجیتال، از پیام‌های متنی شما تا گرافیک خیره‌کننده بازی‌های ویدیویی و هوش مصنوعی، بر پایه همین صفر و یک‌ها ساخته شده است. در طول چهار دهه، صنعت پردازنده از قانونی به نام «مقیاس‌پذیری دنارد» (Dennard Scaling) پیروی می‌کرد. این قاعده فیزیکی که در سال 1974 مطرح شد، می‌گفت هرچه ترانزیستورها کوچکتر شوند، ولتاژ کمتری برای روشن و خاموش شدن نیاز دارند و در نتیجه، سرعت پردازنده بالا رفته و مصرف انرژی آن بهینه می‌شود. این یک بازی برد-برد مطلق بود. شرکت‌هایی مانند اینتل، ای‌ام‌دی (AMD) و بعدها تی‌اس‌ام‌سی (TSMC)، هر دو سال یک‌بار نسل جدیدی از پردازنده‌ها را با ترانزیستورهای کوچکتر معرفی می‌کردند. از ابعاد میکرومتری در دهه 80، به فناوری‌های 90 نانومتری، 45 نانومتری و در نهایت 14 نانومتری رسیدیم. به نظر می‌رسید مهندسان سیلیکون‌ولی در حال بازی با کدهای تقلب کیهان هستند. اما طبیعت همیشه آخرین حرف را می‌زند. Gordon Moore and Moore's Law فصل دوم: کابوس اتمی و پدیده تونل‌زنی کوانتومی مشکل از جایی شروع شد که ابعاد ترانزیستورها به طرز وحشتناکی به اندازه خود اتم‌ها نزدیک شد. برای درک این مقیاس، در نظر بگیرید که قطر یک تار موی انسان حدود 80000 تا 100000 نانومتر است. امروزه ما در حال صحبت درباره ترانزیستورهایی هستیم که گیت (دروازه کنترل‌کننده جریان الکترون) در آن‌ها تنها چند نانومتر ضخامت دارد؛ یعنی به معنای واقعی کلمه، عرض این دروازه تنها از چند ده اتم سیلیکون تشکیل شده است! READ مدیاتک تراشه Kompanio 900T را برای تبلت‌‌ها و لپ‌تاپ‌ها معرفی کرداینجا بود که مهندسان با پدیده‌ای ترسناک در فیزیک روبرو شدند: «تونل‌زنی کوانتومی» (Quantum Tunneling). در فیزیک کلاسیک، ترانزیستور شبیه به یک شیر آب است. وقتی شیر را می‌بندید (حالت خاموش)، جریان آب متوقف می‌شود. اما در ابعاد زیر 10 نانومتر، فیزیک کلاسیک فرو می‌ریزد و قوانین عجیب مکانیک کوانتوم حاکم می‌شود. در این ابعاد، الکترون‌ها دیگر مانند توپ‌های بیلیارد رفتار نمی‌کنند که به در بسته برخورد کنند و متوقف شوند؛ بلکه آن‌ها طبیعت موجی پیدا می‌کنند. تونل‌زنی کوانتومی به زبان ساده یعنی الکترون با دیدن یک دیوار نازک (گیت ترانزیستور در حالت خاموش)، به جای توقف، از داخل دیوار «تونل» می‌زند و در طرف دیگر ظاهر می‌شود! این یعنی کلید خاموش، دیگر کاملاً خاموش نیست. ترانزیستور شروع به نشتی جریان (Leakage) می‌کند. وقتی شما میلیاردها ترانزیستور در حال نشتی روی یک تراشه به اندازه ناخن انگشت خود داشته باشید، نتیجه یک فاجعه حرارتی است. تراشه به جای پردازش اطلاعات، به یک بخاری برقی مینیاتوری تبدیل می‌شود. این محدودیت فیزیکی، اولین میخ بر تابوت قانون مور بود. Gordon Moore and Moore's Law فصل سوم: دیوار حرارتی و سیلیکون تاریک (Dark Silicon) به دلیل همین نشتی‌های کوانتومی و مقاومت الکتریکی سیم‌های فوق‌باریک مسی در داخل تراشه، پدیده‌ای به نام «دیوار حرارتی» (Thermal Wall) در اوایل دهه 2000 میلادی ظاهر شد. تا پیش از آن، شرکت‌ها با کوچک شدن ترانزیستورها، فرکانس پردازنده (Clock Speed) را به شدت بالا می‌بردند. به سرعت از 1 گیگاهرتز به 2 و 3 گیگاهرتز رسیدیم. اما ناگهان در حدود 4 تا 5 گیگاهرتز، رشد متوقف شد. تراشه‌ها به قدری داغ می‌شدند که اگر با همان سرعت قبلی پیش می‌رفتند، دمای سطح پردازنده از دمای سطح خورشید فراتر می‌رفت! در اینجا مفهوم تلخی به نام «سیلیکون تاریک» (Dark Silicon) متولد شد. READ نسخه آزمایشی فایرفاکس برای لپ‌تاپ‌های ویندوز 10 با پردازنده ARM منتشر شدسیلیکون تاریک به این معناست که اگرچه مهندسان توانسته‌اند میلیاردها ترانزیستور را روی یک چیپ جای دهند، اما نمی‌توانند همه آن‌ها را به طور همزمان روشن کنند، زیرا تراشه از شدت گرما ذوب خواهد شد. بنابراین، در هر لحظه، بخش بزرگی از سیلیکون روی پردازنده باید خاموش (تاریک) بماند تا حرارت دفع شود. این یعنی ما ترانزیستورهای بیشتری داریم، اما نمی‌توانیم از تمام پتانسیل آن‌ها استفاده کنیم. فصل چهارم: معجزه‌های معماری؛ از FinFET تا GAAFET با رسیدن به بن‌بست کوانتومی و حرارتی، مهندسان تسلیم نشدند. آن‌ها معماری تخت (Planar) ترانزیستورها را که از دهه 60 میلادی ثابت بود، دور انداختند و به بعد سوم روی آوردند. در سال 2011، اینتل با معرفی ترانزیستورهای سه‌بعدی به نام FinFET (ترانزیستور اثر میدانی باله‌دار) جهان را شگفت‌زده کرد. در این معماری، کانال عبور الکترون‌ها از حالت یک سطح صاف خارج شد و مانند باله یک کوسه به سمت بالا آمد. گیت کنترل‌کننده توانست این باله را از سه طرف در آغوش بگیرد. این کار باعث شد کنترل بر جریان الکترون‌ها به شدت افزایش یابد و نشتی کوانتومی مهار شود. فناوری FinFET توانست قانون مور را برای یک دهه دیگر زنده نگه دارد و ما را به گره‌های پردازشی 7 و 5 نانومتری رساند. اما در ابعاد 3 نانومتر و کوچکتر، حتی FinFET هم پاسخگو نبود. الکترون‌ها دوباره شروع به فرار کردند. این بار، شرکت‌هایی نظیر سامسونگ و تی‌اس‌ام‌سی به سراغ معماری پیچیده‌تری به نام GAAFET (گیت همه‌جانبه) رفتند. در این روش، کانال‌های عبور الکترون به شکل نوارهای نانومتری درآمده و گیت مانند یک تونل، کاملاً دور تا دور آن‌ها را می‌پوشاند تا الکترون‌ها هیچ راه فراری نداشته باشند. تولید چنین ساختارهای ظریفی در سطح اتمی، یکی از بزرگترین دستاوردهای تاریخ مهندسی بشر محسوب می‌شود. فصل پنجم: قانون دوم مور و دستگاه‌های 300 میلیون دلاری مرگ قانون مور تنها ریشه فیزیکی ندارد؛ بلکه اقتصادی نیز هست. گوردون مور قانونی دوم نیز داشت که کمتر شنیده شده است (معروف به قانون راک). این قانون می‌گوید هزینه ساخت کارخانه‌های تولید تراشه (Fab) هر چهار سال دو برابر می‌شود. امروزه، چاپ ترانزیستورهای 3 نانومتری نیازمند دستگاه‌های فوتولیتوگرافی فرابنفش فرین (EUV) است. تنها یک شرکت در جهان به نام ASML در هلند قادر به ساخت این غول‌های مکانیکی است. هر دستگاه EUV به اندازه یک اتوبوس است، بیش از 100000 قطعه دارد و قیمت آن مرز 300 میلیون دلار را رد کرده است! READ هوآوی چیپست کایرین 970 را عامل برتری خود در مقابل اپل و سامسونگ می داندساخت یک کارخانه جدید تولید پردازنده در لبه تکنولوژی، امروز بین 15 تا 20 میلیارد دلار هزینه دارد. این ارقام نجومی باعث شده تا از ده‌ها شرکت تولیدکننده سیلیکون در دهه 90، امروز تنها سه غول بزرگ در خط مقدم باقی بمانند: TSMC، سامسونگ و اینتل. هزینه تحقیق و توسعه به قدری سرسام‌آور شده که کوچک‌سازی بیشتر، دیگر از نظر اقتصادی برای بسیاری از کاربردها منطقی نیست. فصل ششم: استراتژی‌های بقا در دوران پسا-مور با کند شدن روند کوچک‌سازی، صنعت متوجه شد که اتکا به پردازنده‌های همه‌کاره (CPU) دیگر جوابگو نیست. ما وارد عصر «محاسبات ناهمگن» (Heterogeneous Computing) شده‌ایم. امروزه به جای ساخت یک پردازنده غول‌پیکر و گران‌قیمت یکپارچه، شرکت‌هایی مانند AMD و اینتل از معماری «چیپلت» (Chiplet) استفاده می‌کنند. در این روش، پردازنده بزرگ به قطعات کوچکتر (چیپلت) تقسیم می‌شود که هر کدام می‌توانند با فناوری‌های متفاوتی ساخته شوند و سپس با استفاده از پکیجینگ پیشرفته سه‌بعدی به هم متصل گردند. این کار هزینه‌ها را به شدت کاهش داده و محدودیت‌های فیزیکی را دور می‌زند. علاوه بر این، ظهور سخت‌افزارهای تخصصی مانند شتاب‌دهنده‌های هوش مصنوعی (NPU)، واحدهای پردازش گرافیکی (GPU) بسیار قدرتمند و تراشه‌های اختصاصی (مانند TPU گوگل یا سیلیکون‌های اختصاصی اپل M-Series)، نشان می‌دهد که آینده از آنِ طراحی‌های هوشمندانه‌تر است، نه صرفاً ترانزیستورهای ریزتر. جمع‌بندی: پایانی برای یک آغاز قانون مور نمرده است، بلکه تکامل یافته است. شاید دیگر نتوانیم با همان سرعت دیوانه‌وار دهه 90، ابعاد ترانزیستورها را نصف کنیم و به دیوارهای فیزیک کوانتوم برخورد کرده باشیم؛ اما عطش انسان برای قدرت پردازشی متوقف نشده است. همان‌طور که عصر موتورهای بخار جای خود را به موتورهای احتراق داخلی داد، عصر طلایی سیلیکون سنتی نیز در حال واگذاری میدان به معماری‌های سه‌بعدی، پکیجینگ‌های پیچیده، فوتونیک (پردازش با نور) و در نهایت کامپیوترهای کوانتومی است. مهندسان به ما نشان داده‌اند که وقتی دری در فیزیک بسته می‌شود، آن‌ها دیوار را برای یافتن پنجره‌ای جدید خراب می‌کنند. پایان معماری‌های سنتی سیلیکون، کابوسی بود که مهندسان را بیدار کرد تا رویاهای بزرگتر و عجیب‌تری برای آینده فناوری ببینند.

مدیر 4 ماه قبل
1 دقیقه زمان مطالعه

تغییرات بزرگ در راه مک‌بوک؛ اپل نسل جدید تراشه‌ها را آماده می‌کند

تغییرات بزرگ در راه مک‌بوک؛ اپل نسل جدید تراشه‌ها را آماده می‌کنداپل بی‌سروصدا در حال ایجاد تغییراتی اساسی در مسیر توسعه تراشه‌های مک‌بوک است و اگر قصد دارید برای نسل بعدی صبر کنید، ممکن است این تصمیم به ضررتان تمام شود. اپل در حال تغییر برنامه مربوط به تراشه‌های قدرتمند سری M است و مارک گورمن از بلومبرگ جزئیات این تغییرات را منتشر کرده است. طبق این گزارش، تراشه استاندارد M6 همچنان امسال معرفی خواهد شد، اما مدل‌های Pro، Max و Ultra مستقیماً به نسل M7 منتقل می‌شوند. همچنین نخستین مک‌بوک پرو مجهز به نمایشگر لمسی با تراشه‌های M5 Pro و M5 Max عرضه خواهد شد و پس از آن نوبت به مک استودیو می‌رسد. اپل از معرفی نسخه‌های قدرتمند M6 صرف‌نظر می‌کندمارک گورمن در تازه‌ترین خبرنامه Power On خود اعلام کرده اپل قصد دارد ترتیب عرضه تراشه‌های سری M را تغییر دهد. بر اساس اطلاعات او، نسخه پایه M6 طبق برنامه در سال جاری رونمایی می‌شود، اما مدل‌های Pro، Max و Ultra دیگر با نام M6 معرفی نخواهند شد و مستقیماً به خانواده M7 منتقل می‌شوند. با توجه به سابقه قابل اعتماد گورمن در افشای برنامه‌های اپل، این گزارش اهمیت زیادی دارد، هرچند احتمال تغییر در برنامه‌های آینده همچنان وجود خواهد داشت. این تغییر، بیش از هر محصول دیگری روی مک‌بوک پرو لمسی تأثیر می‌گذارد. ما پیش‌تر گزارش‌هایی را دیده بودیم که نشان می‌داد این مدل با طراحی جدید قرار است از تراشه‌های M6 استفاده کند، اما اکنون گورمن می‌گوید نخستین نسخه آن با تراشه‌های M5 Pro و M5 Max روانه بازار خواهد شد و نسخه مجهز به M7 نیز هم‌اکنون در دست توسعه قرار دارد. دلیل اصلی این تغییر، هوش مصنوعی استبرای بیشتر کاربران، نکته مهم‌تر از نام تراشه‌ها، دلیل این جابه‌جایی است. در گزارش توضیح داده شده که این تصمیم به افزایش استفاده از قابلیت‌های هوش مصنوعی روی خود دستگاه ارتباط دارد؛ پردازش‌هایی که بدون وابستگی به فضای ابری انجام می‌شوند، فشار زیادی به سخت‌افزار وارد می‌کنند و گرمای بیشتری تولید خواهند کرد. این تغییرات در مک استودیو بیش از هر محصول دیگری دیده می‌شود. ما پیش‌تر نیز به تأخیر این محصول به دلیل محدودیت‌های حافظه اشاره کرده بودیم. اکنون گورمن می‌گوید نسخه مجهز به M5 Ultra امسال عرضه خواهد شد و مدل دارای M7 Ultra برای سال ۲۰۲۸ برنامه‌ریزی شده. همچنین اپل در حال بازطراحی بخش‌های داخلی این دستگاه است و از جمله قصد دارد سیستم دفع حرارت بهتری برای مدیریت پردازش‌های سنگین هوش مصنوعی در آن به کار بگیرد. اگر قصد خرید یک رایانه رومیزی یا ورک‌استیشن از برندهای رقیب را دارید، این تغییرات فعلاً تأثیر مستقیمی بر تصمیم شما نخواهد داشت. آنچه تاکنون منتشر شده، بیشتر به تغییرات داخلی در طراحی حرارتی و زمان‌بندی عرضه محصولات مربوط می‌شود و نشانه‌ای از آغاز یک رقابت جدید بر سر مشخصات فنی نیست. این تغییرات برای چه افرادی اهمیت دارد؟اگر به‌تازگی یک مک مجهز به تراشه M5 یا M5 Pro خریداری کرده‌اید، دلیلی برای نگرانی یا پشیمانی وجود ندارد، زیرا این بازنگری تنها به محصولات آینده مربوط می‌شود و تأثیری بر دستگاهی که اکنون در اختیار دارید ندارد. در مقابل، افرادی که منتظر عرضه مک‌بوک پرو لمسی یا نسل جدید مک استودیو هستند، بهتر است این اطلاعات را در نظر داشته باشند. بر اساس وضعیت فعلی، ارتقای بزرگ‌تر به نسل M7 برای مدل‌های بعدی در نظر گرفته شده است؛ بنابراین کسانی که به دنبال کامل‌ترین نسخه این محصولات هستند، احتمالاً باید تا زمان عرضه خانواده M7 مدت بیشتری منتظر بمانند. همه ما مشتاق هستیم مک‌بوک پرو لمسی را ببینیم و امیدواریم این محصول ارزش این همه انتظار را داشته باشد. اما داشتن یک مک که همین حالا روی میز کارمان قرار دارد و بدون مشکل نیازهایمان را برطرف می‌کند، بسیار بهتر از محصولی است که عرضه آن مدام به آینده موکول می‌شود.

مدیر 4 ماه قبل
1 دقیقه زمان مطالعه

جزئیات تازه‌ای از پردازنده‌های AMD Zen 6 فاش شد

جزئیات تازه‌ای از پردازنده‌های AMD Zen 6 فاش شدپردازنده‌های AMD Zen 6 با نام رمز “Olympic Ridge”، واحد پردازش گرافیکی یکپارچه (iGPU) را کنار گذاشته و به جای آن از واحد پردازش عصبی (NPU) بهره خواهند برد. جزئیات بیشتری درباره معماری نسل بعدی رایزن AMD که با نام رمز “Olympic Ridge” شناخته می‌شود، در حال آشکار شدن است. معماری پردازنده‌های سری Ryzen 10000 مبتنی بر Zen 6 خواهد بود، مگر اینکه AMD تصمیم بگیرد نام‌گذاری خود را تغییر دهد. طبق گزارش جدید، AMD در حال تغییر چیدمان داخلی این تراشه‌ها است تا به جای iGPU، یک NPU را ادغام کند. این گزارش توسط افشاگر Gotou_kai3@ در ایکس منتشر شده و سپس توسط Wccftech تایید شده است. بر اساس این افشاگری، پردازنده‌های Zen 6 دیگر دارای پردازنده گرافیکی یکپارچه نخواهند بود و به جای آن از فضای موجود برای NPU (واحد پردازش عصبی) استفاده خواهد شد. این یک تصمیم عجیب است، زیرا AMD تنها با سری Ryzen 7000 شروع به قرار دادن iGPU در پردازنده‌های دسکتاپ رایزن کرده بود. علاوه بر این، ادغام NPU سوال‌برانگیز است. AMD در حال حاضر یک NPU در APUهای دسکتاپ AM5 و مینی‌پی‌سی AI Halo ارائه می‌دهد، اما به نظر می‌رسد این اولین پردازنده‌های مستقل AMD باشند که از NPU بهره می‌برند. با این حال، استفاده از NPU در حال حاضر نسبتاً محدود است. از نظر تئوری، می‌توان از آن‌ها برای ساده‌سازی پردازش هوش مصنوعی در سطح تراشه استفاده کرد، اما جایگزینی iGPU با این قابلیت خاص کمی گیج‌کننده است. نبود iGPU، تطبیق‌پذیری پردازنده را محدود می‌کند و تشخیص مشکلات مربوط به ویدیو را بسیار دشوارتر خواهد کرد. با این وجود، اکثر کاربران Zen 6 به احتمال زیاد پردازنده را با یک کارت گرافیک اختصاصی جفت خواهند نمود، اما داشتن iGPU به عنوان یک پشتیبان، صرف نظر از همه اینها، مفید است. این افشاگری همچنین بیان می‌کند که پردازنده‌های Olympic Ridge از پشتیبانی CUDIMM (یک استاندارد جدیدتر برای حافظه سریع‌تر) برخوردار خواهند شد. در کنار این، معماری جدید از ویژگی‌های EXPO 1.2، وای‌فای ۷، ورودی/خروجی بهبود یافته و حافظه DDR5 سریع‌تر پشتیبانی می‌کند. معماری Zen 6 و پردازنده‌های AMD Ryzen مبتنی بر آن در حال حاضر برای سال ۲۰۲۷ برنامه‌ریزی شده‌اند. گفته می‌شود که آن‌ها روی گره ۲ نانومتری “N2P” شرکت TSMC تولید می‌شوند و احتمالاً پیشرفت‌های قابل توجهی در عملکرد و بهره‌وری خواهند داشت. طبق افشاگری‌های قبلی، CCD پردازنده‌های Zen 6 Olympic Ridge تا ۱۲ هسته و ۴۸ مگابایت حافظه کش L3 را شامل می‌شود و AMD می‌تواند دو تا از این CCDها را برای ایجاد یک مدل پرچمدار ۲۴ هسته‌ای جفت کند. همچنین می‌توانیم انتظار پیاده‌سازی 3D V-Cache را در آینده داشته باشیم. با توجه به عرضه اخیر Ryzen 9 9950X3D2، بعید نیست که AMD کش را روی مدل رده بالای Zen 6 نیز به صورت دو لایه قرار دهد. صرف نظر از این، جالب خواهد بود که ببینیم Zen 6 چگونه در برابر Intel Nova Lake-S که اوایل سال آینده میلادی عرضه می‌شود، قرار می‌گیرد.

مدیر 4 ماه قبل
1 دقیقه زمان مطالعه

پردازنده‌های اینتل با گرافیک RTX انویدیا در سه‌ماهه اول ۲۰۲۸ معرفی خواهند شد

پردازنده‌های اینتل با گرافیک RTX انویدیا در سه‌ماهه اول ۲۰۲۸ معرفی خواهند شدپردازنده‌های اینتل با گرافیک انویدیا RTX در سه ماهه اول سال ۲۰۲۸ عرضه خواهند شد. نزدیک به یک سال از زمانی که اینتل و انویدیا به طور رسمی همکاری خود برای ساخت محصولات جدید را اعلام کردند می‌گذرد و از آن زمان تاکنون اطلاعات کمی درباره ماهیت واقعی این محصولات شنیده‌ایم. لیپ-بو تان، مدیر عامل اینتل، اخیراً تأیید کرد که این همکاری برای توسعه محصولات جدید و هیجان‌انگیز ادامه دارد که منجر به گمانه‌زنی‌های بیشتری شده است. حالا به نظر می‌رسد تصویر واضح‌تری از محتوای این همکاری به دست آورده‌ایم. طبق گزارشی از ویدیوکاردز به نقل از اردی اوزوآگ، سردبیر یک سایت فناوری ترکیه‌ای، اولین پردازنده‌های x86 اینتل با گرافیک یکپارچه انویدیا RTX در سال ۲۰۲۸ وارد بازار می‌شوند. به طور دقیق‌تر، طبق گفته‌های اردی اوزوآگ که ادعا می‌کند نقشه راه پردازنده‌های اینتل را دیده است، این پردازنده‌های که با همکاری مشترک ساخته شده‌اند، برای معرفی در سه ماهه اول سال ۲۰۲۸ برنامه‌ریزی شده‌اند. این خبر بزرگی است که بلافاصله پس از معرفی RTX Spark انویدیا منتشر شده و پرسش‌های بسیاری را درباره چگونگی رابطه بین این سه غول دنیای فناوری ایجاد می‌کند. از یک سو، همکاری انویدیا و اینتل روی یک پردازنده x86 خبری بسیار مهم است. گرافیک‌های انویدیا RTX Blackwell قلب تپنده تراشه‌های جدید اسپارک آن‌ها هستند، اما این گرافیک‌ها به جای هسته‌های x86 با هسته‌های آرم جفت شده‌اند. این یعنی بعید است که این دو محصول در رقابت مستقیم با یکدیگر باشند؛ با این حال، به نظر می‌رسد هدف این همکاری، رقابت با ای‌ام‌دی و سری پردازنده‌های Ryzen AI آن است. این افشاگری همچنین بیان می‌کند که اگر برنامه‌ها تغییر نکند، می‌توانیم شاهد رونمایی رسمی این پردازنده‌ها در نمایشگاه سی‌ای‌اس ۲۰۲۸ باشیم. اوزوآگ با شفاف‌سازی بیشتر در مورد وضعیت زنجیره تأمین، اظهار داشته که ظاهراً اپل نیز در این میان حضور دارد و برای نسل بعدی تراشه‌های سری M خود از اینتل کمک می‌گیرد که انتظار می‌رود با استفاده از فرآیند 18A تولید شوند. اگر بخواهیم دوباره به همکاری انویدیا و اینتل بازگردیم، این پردازنده‌های نسل بعدی احتمالاً بخشی از سری Serpent Lake اینتل هستند که انتظار می‌رود هم عملکرد گرافیکی و هم توان محاسباتی را هدف قرار دهند. جزئیات این سری بسیار اندک است، زیرا جدول زمانی آن نشان می‌دهد که نزدیک به یک و نیم سال تا عرضه آن باقی مانده است. ما ایده روشنی از محل تولید این پردازنده‌ها نداریم، اما به نظر می‌رسد گره 18A-P اینتل محتمل‌ترین گزینه برای تولید آن‌ها باشد. باید به خاطر داشت که این اولین زوج بعید در دنیای پردازنده‌ها نیست. خود اینتل در سال ۲۰۱۸ با رقیب دیرینه‌اش یعنی ای‌ام‌دی روی سری پردازنده‌های Kaby Lake-G همکاری کرد. آن پردازنده‌ها گرافیک‌های Vega ای‌ام‌دی را در خود جای داده بودند و با فرآیند ۱۴ نانومتری ساخته شده بودند. ما از آن زمان مسیر طولانی را طی کرده‌ایم و پردازنده‌های RTX اینتل که در راه هستند بسیار هیجان‌انگیزتر از نمونه‌های قبلی به نظر می‌رسند.

مدیر 4 ماه قبل
کالا هایی که دیده ایید !
شما این محصولات را انتخاب کرده اید0
empty-cart

هیچ محصولی در سبد خرید نیست.

جهت مشاهده محصولات بیشتر به صفحات زیر مراجعه نمایید.
کامپیوتر همه کاره 18.5 اینچ مدل PC185I52B

حسین نیکوکار

کامپیوتر همه کاره 18.5 اینچ مدل PC185I52B
9 روز پیش خریداری شدهتایید شده